Как я 4 раза проиграл локальным LLM-моделям: распознавание речи, замеры, линейка качества и маскирование персональных данных
Я делал для центра здоровья сервис, который превращает часовой надиктованный разбор сессии в карточку клиента. Данные чувствительные, поэтому ставка была простая: всё считать у себя. Распознавание речи локально заработало. А локальные LLM-модели провалились четыре раза подряд: 7 часов 29 минут счёта сервера и ноль карточек. Две модели упали с ошибкой, две молча работали вхолостую, и ни одна не сказала, в чём дело. Разбираю, что ломалось, как это ловить за минуту, чем мерить качество и как отправлять текст во внешнюю модель без имён.
// Интеллект-карта статьи развернуть
По выступлению Евгения Ганимара на закрытом факультете NeyroMakers клуба NeyroCommunity PROТекст — Евгений ГанимарРедактор — Андрей Плешков
Опубликовано Проверено Чтение ≈ 20 мин
Выпуск № 17 «Без розовых очков» · приложение · бонусный хак
// Коротко
- Что получишь
- Три числа, которые надо проверить у модели до запуска; таблица четырёх провалов с признаками, по которым они ловятся за минуту; линейка качества из трёх чисел; порядок выбора модели из шести шагов; схема маскирования персональных данных перед внешней моделью и три вопроса провайдеру.
- Задача
- Как понять, справится ли локальная LLM с задачей на своём железе, до долгих прогонов; честно сравнить модели; безопасно отправить текст с персональными данными во внешнюю модель. Материал — вайбкодерам и разработчикам ИИ-сервисов, которые хотят поставить локальную нейросеть на свой сервер или ноутбук ради персональных данных, и тем, кто выбирает модель для заказчика.
- Ограничения
- Это один проект: сервер на 4 ядрах и 6 ГБ памяти без видеокарты, ноутбук на 16 ГБ, длинные записи на русском. Это не рейтинг моделей: на другом железе и с другой задачей локальные модели могут справиться. Не проверены заполнение карточки по одному разделу за запрос и модель с большим окном на сервере с видеокартой.
- Цены моделей — снимок на 10 сентября 2026 года, рабочая схема — на сентябрь 2026. Перед выбором сверь цены и названия у провайдера.
- Данные клиентов в примерах вымышленные. Схема маскирования — технический подход, а не юридическая консультация: за схему конкретного бизнеса отвечает его юрист.
Задача выглядела как идеальный кейс для локальных моделей. Специалист центра здоровья после сессии надиктовывает разбор: 40–60 минут речи о том, с чем пришёл клиент. Сервис должен разложить запись по карточке из 13 разделов и 30 полей, причём словами клиента, а не своими. Голос, диагноз, рассказ о жизни — это персональные данные, а цена ошибки — репутация центра. Отсюда гипотеза: раз распознавание речи работает у нас на сервере, пусть и разбор текста работает у нас. Локальные LLM-модели, свой сервер, ни байта наружу.
Гипотеза звучала безупречно, на неё я закладывал выходные. Ушло две недели — и ни одной готовой карточки.
Ниже — по порядку: распознавание речи, четыре провала, как мерить качество, почему в итоге текст разбирает зарубежная модель и как туда уходит текст без имён. В конце — порядок, в котором я бы выбирал модель сейчас, и мои правила для ИИ-агента.
Распознавание речи: почему в бою медленный Whisper large-v3-turbo
Голос обезличить нельзя: сам звук и есть примета человека. Поэтому распознавание обязано идти внутри контура, на своём сервере, — это решение не обсуждалось. Обсуждалось, какой движок.
Я взял один и тот же кусок записи в 4 минуты и прогнал три движка по очереди на трёх ядрах без видеокарты:
| Движок | Время на 4 минуты | Вес на диске | Статус |
|---|---|---|---|
| Whisper large-v3-turbo | 128 с | 1,6 ГБ | в бою |
| Whisper small | 68 с | 464 МБ | — |
| GigaAM v3 | 15 с | 216 МБ | кандидат |
GigaAM v3 оказался быстрее нынешнего движка в 8,6 раза: час записи за 3,5 минуты вместо 33, и на диске в 7 раз легче. Очевидный вывод — меняем. Я его не сделал, и вот почему: этот замер мерил скорость, а не правильность.
Тексты движков я сравнил между собой: оба кандидата разошлись с нынешним почти одинаково, на 20,4 % и 20,7 %. Но расхождение — мера различия, а не мера правоты. Чтобы сказать, кто ближе к сказанному, нужен эталон: запись, которую человек расшифровал и вычитал вручную. Такого эталона у проекта нет. Выход простой — слепая вычитка: одна запись, два текста без подписи, решает специалист, это полчаса. Пока её нет, смена движка — лотерея. Поэтому в бою остался large-v3-turbo: он проверен на большом числе боевых записей, и специалист довольна результатом. GigaAM лежит на сервере запасным.
По деньгам распознавание стоит 0 ₽ за любое число записей: платишь только временем сервера. В бою 47 минут записи распознаются примерно за 25 минут. Облачное распознавание того же часа стоило бы от 2,88 до 42,94 ₽, но дело не в экономии, а в голосе.
Как поставить такой распознаватель у себя, мы разбирали в гайде о бесплатной транскрибации на своём компьютере.
Четыре локальные модели — четыре провала
Условия у всех одинаковые: сервер на 4 ядрах и 6 ГБ памяти, рантайм Ollama, эталонная запись на 47 минут — 7383 слова, около 20 000 токенов. Нужно разложить её по 30 полям. Самую крупную модель запускал на ноутбуке: 16 ГБ, из них 11,8 ГБ доступно как видеопамять.
| № | Модель | Вес файла | Память в работе | Окно контекста |
|---|---|---|---|---|
| 1 | qwen2.5:14b | 9,0 ГБ | ~12 ГБ | 32 768 |
| 2 | nemotron-mini | 2,7 ГБ | — | 4 096 |
| 3 | gemma3:4b | 3,3 ГБ | 4,7 ГБ | 131 072 |
| 4 | ruadapt | 3,3 ГБ | 5,4 ГБ | 262 144 |
Все эти цифры были у меня перед глазами до запуска. Я на них не посмотрел. И учти: окно в таблице — максимум модели. Сколько контекста выделено на самом деле, задаётся при запуске, и в Ollama это отдельная настройка — её стоит проверить (документация Ollama о длине контекста).
Провал 1. qwen2.5:14b — модель больше машины
Расчёт был такой: «11,8 больше 9, логично же». Я забыл, что к весу файла прибавляется место под текст, около 3 ГБ. Модели нужно около 12 ГБ, доступно 11,8. Через 2 минуты — Error: POST /api/generate 500, результата нет.
Вывод: вес файла модели — это не её размер в работе. На машине с 16 ГБ потолок — модели около 7 млрд параметров, а не 14. И нет, терабайт диска тут не помогает: модели нужна оперативная память.
Провал 2. nemotron-mini — влезла по весу, но не работает
В память помещалась с запасом и упала мгновенно. Запись нарезали на 5 частей, и каждая дала ContextOverflow: не влезла даже пятая часть. Причина — окно контекста 4096 токенов. Это около 1500 слов вместе с инструкцией, а в записи 7383 слова.
Эта модель хотя бы упала честно. Страшнее другое: во многих локальных сборках окно по умолчанию — 4096 токенов, и длинный текст режется молча и с начала. Вместе с началом пропадает инструкция. Модель отвечает связно, не увидев задания, без ошибки и без следа в журнале.
Провал 3. gemma3:4b — отработала честно и вернула ничего
Подходила по всем параметрам. Считала 10,6 минуты и на каждой из 5 частей вернула «готово, 0 фрагментов». Модель не держала заданную форму ответа: от неё ждали список номеров, а она его не выдавала. Конвейер видел код «успех» и шёл дальше.
Слово «готово» тут врёт. Пустой ответ обязан отличаться от отказа прямо в коде, иначе о поломке узнаешь от клиента.
Провал 4. ruadapt — 68 минут пусто, потом 368 минут пусто
На русскоязычную сборку была главная ставка. Выписки из текста она делала, 163 фрагмента, — значит, подход рабочий. А раскладка по разделам дважды упёрлась в отсечку по времени. Первая попытка: отсечка 30 минут, прогон 68 минут, обрыв, пусто. Я поднял отсечку втрое. Вторая попытка: 368 минут, обрыв, пусто. Шесть часов в одном прогоне и ноль слов на выходе.
Цифра показывала мою отсечку, а не модель. Правильно было взять маленький кусок, замерить время и умножить: минута вместо шести часов.
А настоящая причина оказалась в самом дорогом классе сбоя: модель не упала, а ушла считать на диск. Лимит памяти контейнера — 4 ГБ, модели нужно 5,4. Вместо ошибки — своп. При этом всё выглядело как работа:
ollama psпоказывал 4,0 GB, аdocker stats— 5,4 GB;- процессор был загружен на 108 % (при здоровом счёте — 266 %);
- в журнале — ноль ошибок;
- и только
ps -o statпоказывал у процесса состояниеD— ждёт диск.
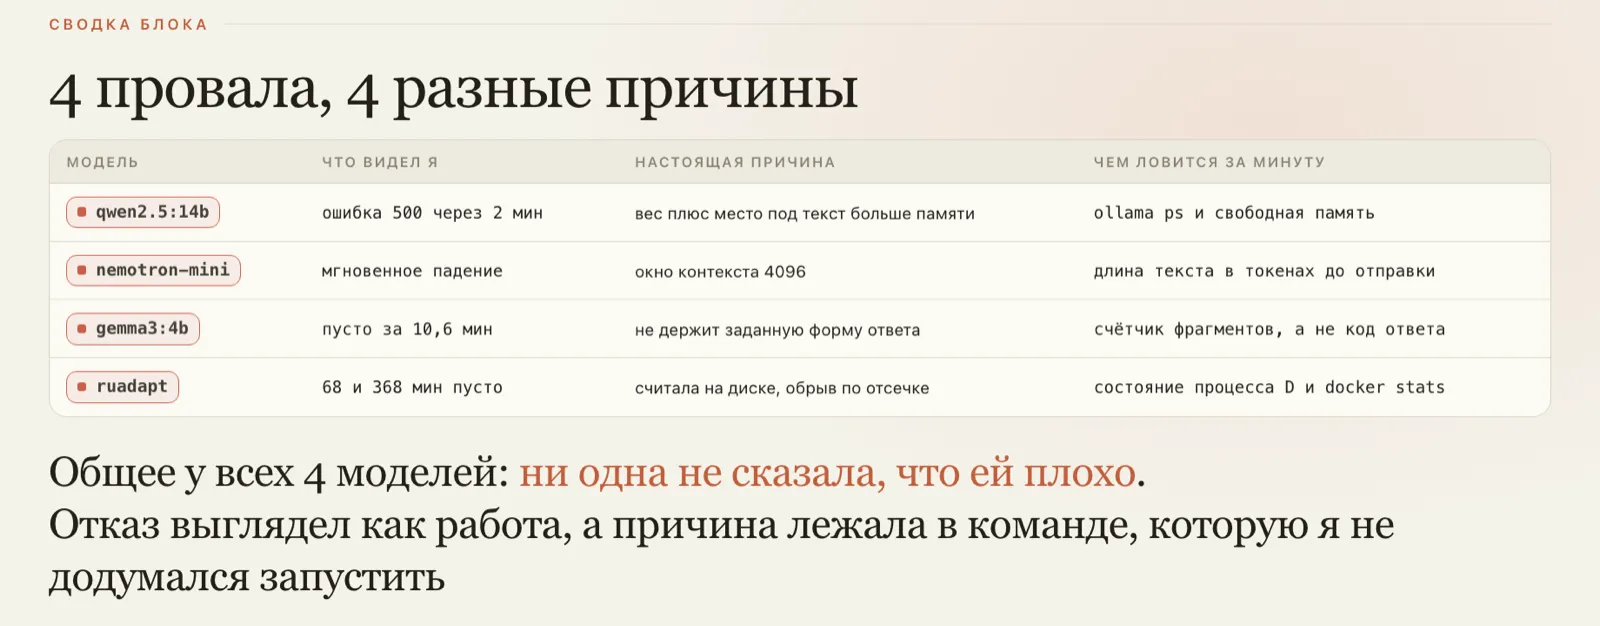
Сводка четырёх провалов — слайд из презентации автора lokalnye-modeli.vercel.app, снимок 28.10.2026.
Общее у всех четырёх: ни одна модель не сказала, в чём проблема. Две упали с ошибкой, но ошибка 500 и переполнение окна не объясняли, что делать. Две другие молчали: «готово» с пустым результатом и часы счёта на диске при нуле ошибок в журнале. Отказ выглядел как работа, а причина каждый раз лежала в команде, которую я не додумался запустить.
Как понять, что локальная модель не справляется
Из четырёх провалов сложилась короткая проверка. Её стоит пройти до любого долгого прогона.
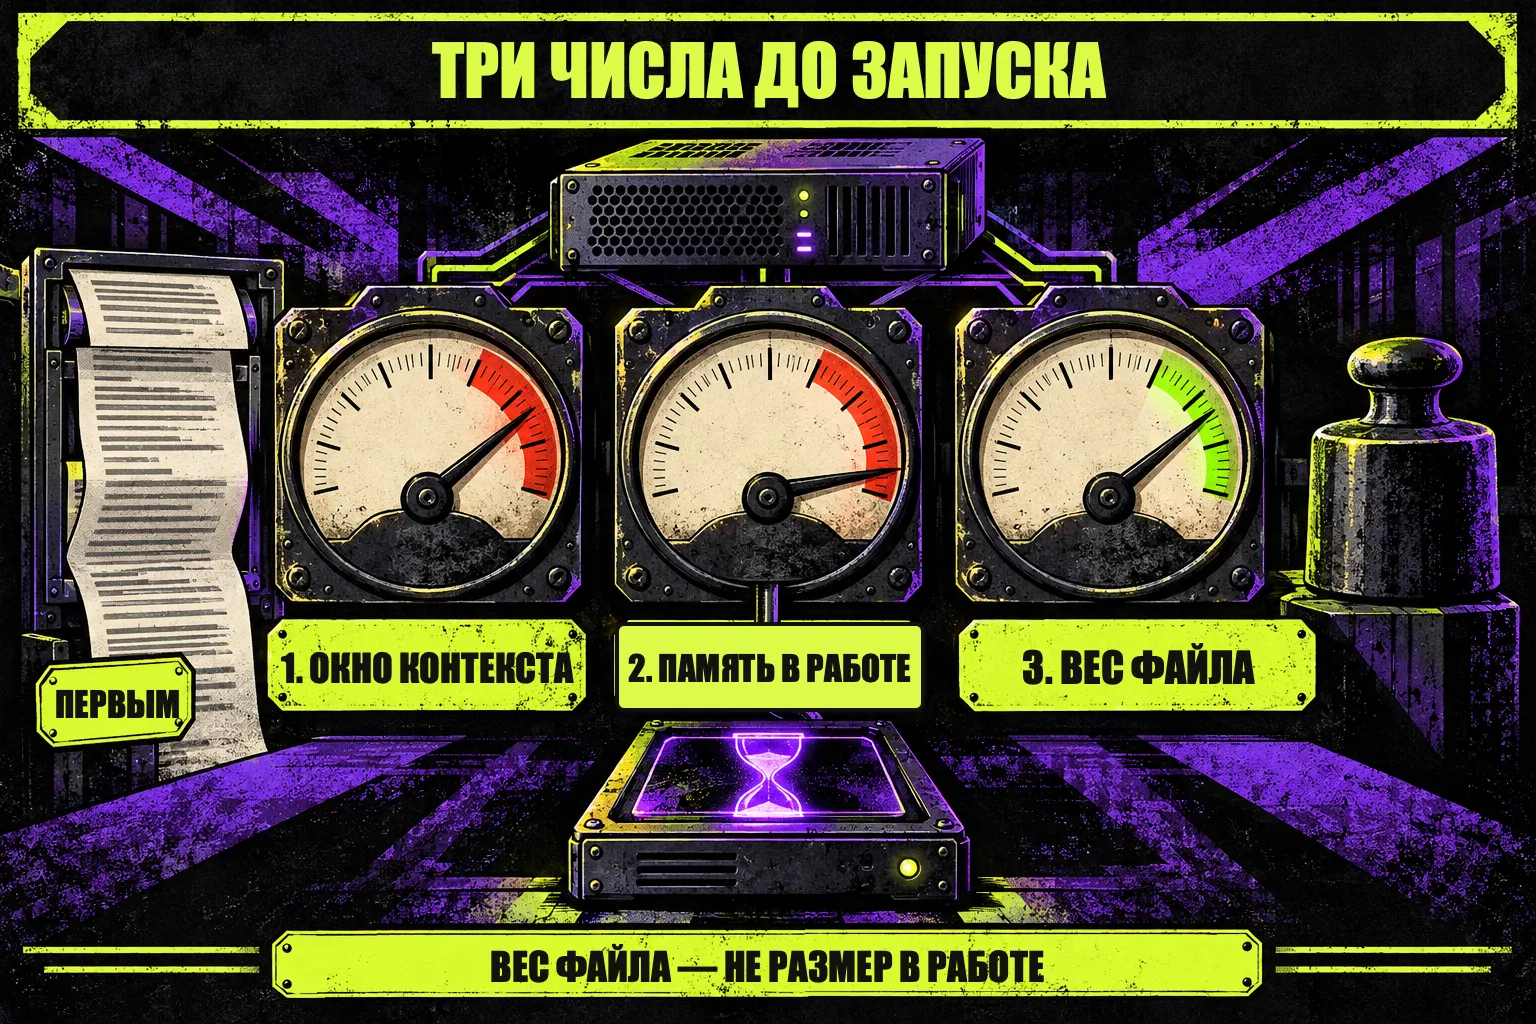
Три числа модели, которые надо проверить до запуска, — и окно первым.
- Окно — первым. Посчитай длину текста в токенах вместе с инструкцией и местом под ответ и сравни с окном модели. Для русского грубо — слова × 2,7. Текст больше окна — модель отсеяна, никакое железо не поможет. Это секунда, а не час.
- Память — со свободной, а не со всей. Вес файла плюс место под текст сравнивай с тем, что реально доступно: в выводе
free -mэто столбецavailable. Если система уже активно пишет в своп, памяти не хватает прямо сейчас. - Сверяй, сколько токенов модель обработала, с тем, сколько ты отправил. Расхождение — молчаливая обрезка.
- Пустой ответ ≠ успех. Считай фрагменты и поля в ответе, а не код ответа.
- Нехватка памяти выглядит как работа. Смотри
docker statsвместоollama ps, состояние процесса (ps -o stat:D— ждёт диск) и занятый своп (free -m). - Сначала замер, потом таймаут. Маленький кусок, замер, умножение — и только потом решение, сколько ждать.
Команды для памяти, окна и счёта на диске — на сервере, пока идёт прогон (пустой ответ ловит не команда, а счётчик полей в твоём коде):
ollama ps                          # какие модели в памяти, сколько занимают, какой контекст выделен
docker stats --no-stream           # сколько контейнер ест на самом деле и где его лимит
free -m                            # available — сколько реально доступно; swap used — ушли ли на диск
ps -o pid,stat,%cpu,cmd -C ollama  # STAT = D: процесс ждёт диск; R: считает
Тревожные признаки: docker stats показывает больше, чем ollama ps, или упирается в лимит контейнера; своп растёт; у процесса состояние D, а загрузка процессора вдвое ниже обычной. Тогда модель не думает — она считает на диске, и ждать бессмысленно.
Прикинуть первые два пункта можно в симуляторе памяти из моей презентации. Двигаешь четыре ползунка — память, вес модели, окно, длина текста, — и он говорит: «не помещается в окно», «не влезает в память», «мало запаса» или «помещается». Формула учебная: вес × 1,35 плюс 0,12 ГБ на каждую 1000 токенов окна, минус 0,7 ГБ на систему. Пресеты воспроизводят модели из кейса.
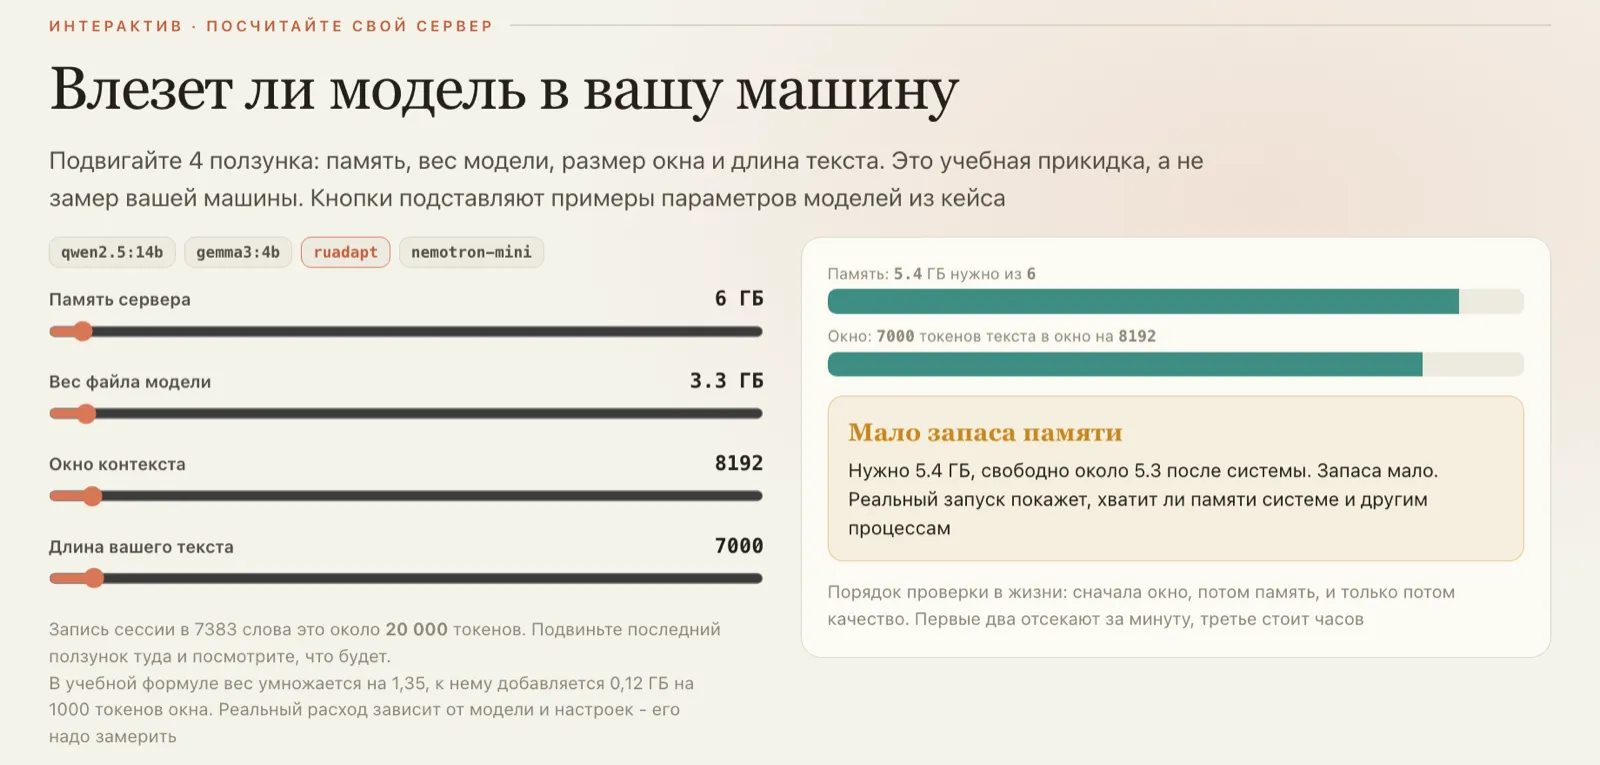
Симулятор памяти — слайд 28 презентации, пресет ruadapt, снимок 28.10.2026. Это прикидка, а не замер твоей машины: проходит симулятор — значит, условие необходимое, но не достаточное.
Гигабайт, который лежал в настройках
Когда всё стало понятно, я нашёл на том же сервере гигабайт за один вечер, ничего не докупая. У бота было выделено 2 ГБ, а ел он 7 МБ. Модель не выгружалась из памяти: удержание по умолчанию — 5 минут — сталкивалось с распознаванием следующей записи, поставили 30 секунд. И место под ответ было зарезервировано на глаз, 8000 токенов, а нужно около 2000.
После этого процесс перестал ждать диск, процессор поднялся со 108 до 266 %, своп упал с 2254 до 318 МБ, ответы пошли за 3–15 минут. Но ruadapt через полтора часа снова уехала на диск и до нужного формата так и не дошла. Ожившая — не значит работающая.
Итог честный: для этой записи на этом сервере рабочего варианта локально не нашлось. Делать вывод обо всех локальных моделях по четырём попыткам я бы не стал.
Почему ИИ врёт, даже когда все тесты пройдены
Провалы локальных моделей — только первая серия. Дальше было интереснее: модели, которые ответ выдавали, ошибались так, что этого не видно.
Гладкий текст неотличим от выдумки. В одном из прогонов gemma3:4b заполнила 22 поля из 30 и выглядела лучшей из всех. Но только 27 % написанного подтверждалось записью: три четверти модель дописала за клиента — то, что обычно говорят такие люди. В карточке живого человека выдуманное поле хуже пустого.
Синтетика завышает. На выдуманной сессии модель дала 89 % опоры на запись, на настоящей — 73 %. Разрыв в 16 пунктов: цифры с придуманного текста на живые данные не переносятся.
Решение живёт дольше своей причины. Нарезку записи на куски по 5500 токенов придумали для локальной модели. Модель убрали, а нарезка осталась в коде, и облачная модель получала резаную запись. Я о ней забыл, Claude тоже забыл. Разрез теряет связи: запрос звучит в начале, ответ на него — в конце. По кускам вышло 19 полей из 29, целиком — 27 из 29. Пиши причину решения рядом с решением.
Зелёные тесты и зелёные сторожа. Все тесты прошли, а клиент пишет: «загрузила запись, но её нет» — мой же ИИ-агент чинил данные на боевом сервере от имени root, и служебный файл сменил владельца. Из 26 моих проверок-сторожей одна сообщала «ошибок нет», потому что после полуночи читала вчерашний журнал. Из 16 поломок проекта сторожа первыми нашли две, клиент — шесть. Проверяй действием пользователя, а не статусом.
Про то, почему нейросети уверенно ошибаются в принципе, — наш разбор галлюцинаций нейросети.
Как сравнивать модели честно: линейка из трёх чисел
Спрашивать у модели, хорошо ли она справилась, — всё равно что спрашивать ученика, доволен ли он своей работой. Качество должен считать код. Моя линейка — три числа:
| Число | Порог | Что ловит |
|---|---|---|
| Опора на запись — доля утверждений карточки, подтверждённых расшифровкой | 70 % | выдумку |
| Худшее поле | 40 % | перекос: девять отличных полей и одно выдуманное дают среднее 80 % |
| Цитаты дословные | все или ничего | пересказ под видом цитаты |
Как это считается. Карточку разбивают на отдельные утверждения, и код ищет каждому опору — фрагмент расшифровки, где это сказано. Условный пример: в карточке три факта, два находятся в записи, третьего там нет — модель дописала его сама. Опора — 2 из 3, то есть 67 %, ниже порога. Порог 70 % я не взял с потолка: вывел его по многим тестам на этих записях. А неподтверждённые утверждения — это и есть то, что должен увидеть человек до того, как карточка уйдёт в работу.
Линейку я записал до замеров: порог — 19 августа, замеры — 20-го, и после замеров порог не двигал. Написанная после, линейка не измеряет, а оправдывает уже выбранную модель. И считать надо полноту и честность вместе: отдельно первая хвалит выдумщика, вторая — молчуна.
У линейки есть дыры, и о них лучше знать заранее. Она не видит, в тот ли раздел положены слова: точная цитата клиента о семье, положенная в раздел о работе, даёт ту же опору, что и на своём месте. Не наказывает за пустоту. И не измеряет, насколько карточка осмысленна. Это выяснилось дорого.
Сообщение, которое отменило мои цифры
После локальных провалов я проверил российское облако: три модели GigaChat на той же записи, с тем же промптом и той же формой ответа. Ожидал лестницу «больше модель — лучше результат». Вышло другое: у каждой модели свои пропуски, все три совпали только в одном поле из 30. Порог взяла только GigaChat-3-Ultra — 73 % опоры. Две недели она работала в бою, и цифры росли.
А потом специалист прислала сообщение: «Слова мои, но всунуты в другие рубрики». И добавила, что самые лучшие разборы были самые первые — их делал человек вручную. Я две недели улучшал то, что клиент не считает проблемой. Линейка измеряла честность, а не смысл.
Слепая вычитка трёх карточек без подписей перевернула и таблицу: специалист выбрала модель, которая проигрывала 12 пунктов опоры и не дала ни одной цитаты, — потому что та была «ближе к сути». Работа линейки — отсечь заведомо негодное, чтобы человек смотрел не на семь вариантов, а на два. Цифра отсеивает, выбирает человек.
И ещё один вывод для бюджета. Если слова верные, а разделы перепутаны, совет «возьми модель помощнее» не поможет: дорогая модель получит то же описание разделов и разложит так же неверно. Вместо апгрейда пусть специалист опишет разделы своими словами — какими фразами про каждый раздел говорят на сессии.
Локальная нейросеть, российское облако или зарубежная модель
Считать ИИ может в трёх местах, и у каждого — свой вопрос:
| Где считается | Плюс | Вопрос | Что вышло у меня |
|---|---|---|---|
| Локально, свой сервер | данные не покидают контур, 0 ₽ за запрос | хватит ли окна, памяти и качества на твоём железе | распознавание — да; разбор текста — 4 провала на 4 ядрах и 6 ГБ без видеокарты |
| Российское облако | текст не уходит за рубеж | что провайдер делает с текстом запроса | GigaChat-3-Ultra взяла порог и две недели работала, потом фильтр провайдера отклонил целую сессию как «похожую на медицинский формат», а на письменный вопрос о хранении запросов ответа нет |
| Зарубежное облако | лучшие модели рынка | отправлять можно только то, из чего заранее вырезаны имена и приметы | сейчас в работе claude-haiku-4.5 через российский шлюз, только маскированный текст |
Как это работает сейчас, в сентябре 2026: запись приходит на свой сервер, large-v3-turbo распознаёт её локально, сервис заменяет имена метками (ключ остаётся у нас), claude-haiku-4.5 разбирает запись целиком одним запросом. Последняя рабочая сессия: 77 % опоры при пороге 70, 12 разделов из 13, 10 из 10 цитат дословные, 14 минут от загрузки до карточки и 4,41 ₽ за разбор. Первые шесть полей карточки я отдал специалисту: машина туда не лезет.
Haiku подключён через Polza.ai (наша спецссылка) — российский шлюз к зарубежным моделям с оплатой в рублях. Как подключить Claude этим путём и что ещё есть на рынке — в гайде «Claude в России через API».
По цене разброс огромный. На снимке от 10 сентября 2026 года для длинной записи разбор стоил от 2,77 ₽ до 415 ₽ — в 150 раз. Haiku в бою — 8,14 ₽ за ту же запись: почти втрое дешевле claude-sonnet-5 (23,87 ₽) при той же раскладке. «Модель помощнее» здесь не давала ничего, кроме счёта.
Иронично, но за те две недели я мог просто взять Haiku от Anthropic, и всё бы работало. Только узнать это можно было лишь замером.
Маскирование персональных данных перед внешней моделью
Это ноу-хау проекта, и оно встроено в процесс, а не написано просьбой в промпте. Защита срабатывает до того, как модель получит текст.
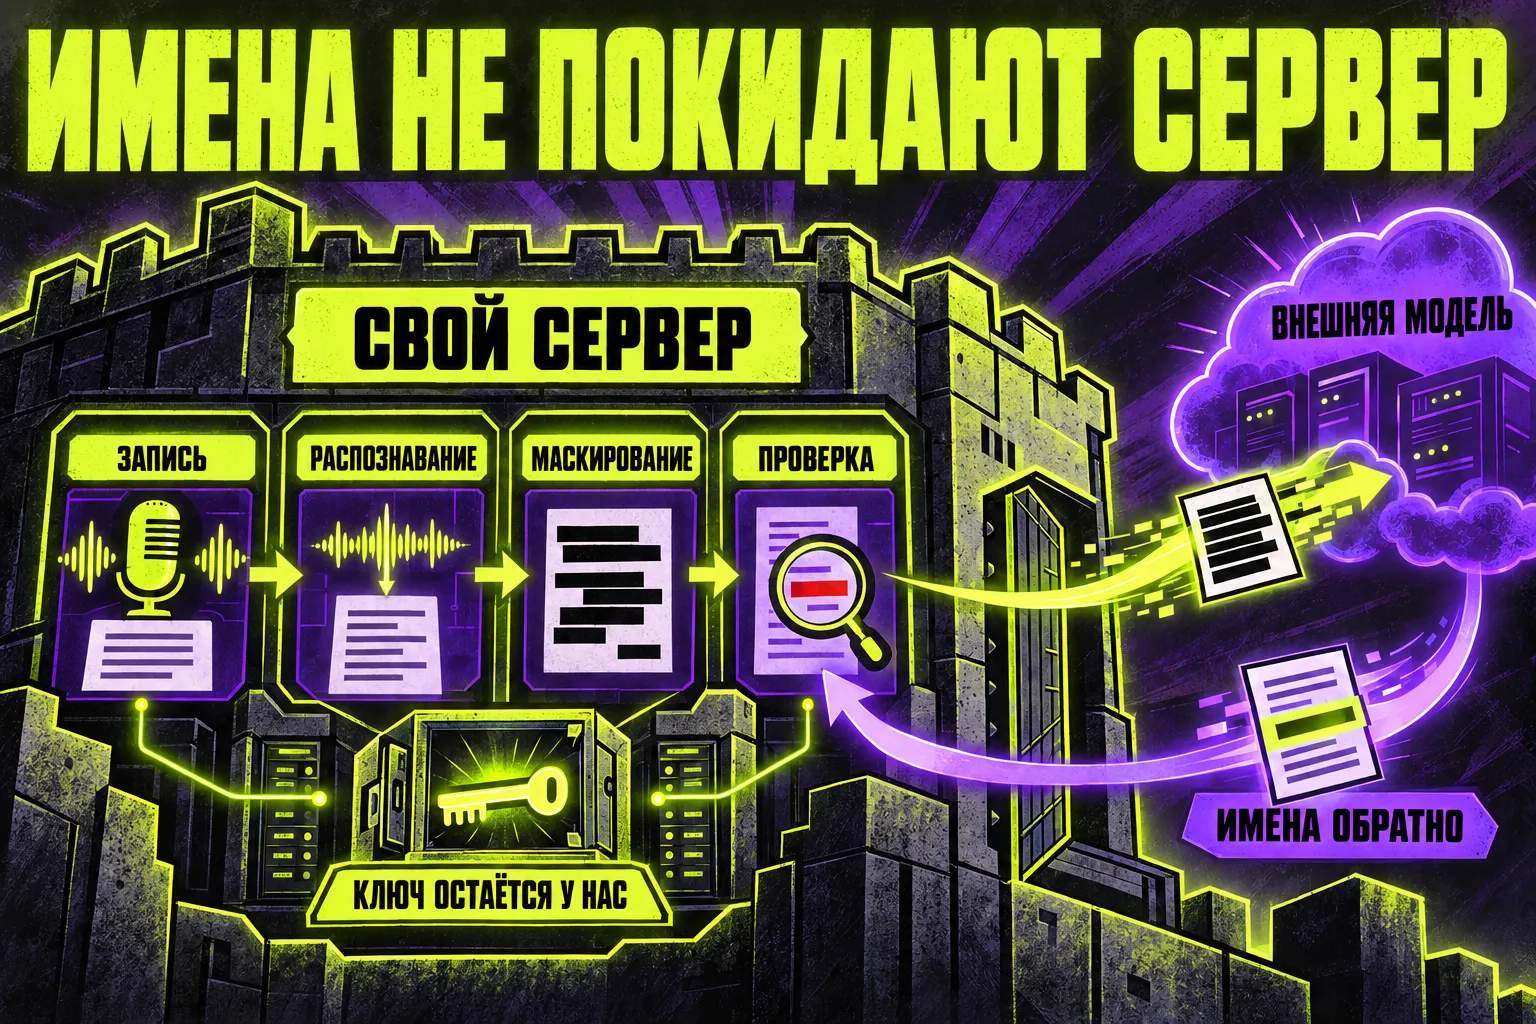
Маршрут записи: всё, что знает имена, остаётся на своём сервере.
Четыре шага:
- Найти и заменить. Имена из карточки клиента ищутся с учётом падежей. Телефоны, почту и номера документов ловят правила. Имена, места и организации дополнительно ищет локальный распознаватель сущностей.
- Проверить перед отправкой. Отдельная проверка ищет пропущенные данные. Нашлись остатки — внешний вызов блокируется. Нет подтверждённого согласия клиента на обработку — тоже блокируется.
- Разобрать текст. Модель получает текст с метками вида
[ЛИЦО_1]и[КОНТАКТ_1]. Одинаковая метка — один и тот же человек во всей записи, родственные роли сохраняются, поэтому модель разбирает отношения, не зная имён. Таблица соответствий остаётся в памяти процесса на нашем сервере и модели не отправляется. - Вернуть имена. Сервис подставляет исходные данные в ответ до показа специалисту. Ему не нужно вручную скрывать и восстанавливать имена.
Пример (вымышленный): «Обсуждала ситуацию с Александром Сергеевичем Ковалёвым. Позвонить ему: +7 900 000-00-00» превращается в «Обсуждала ситуацию с [ЛИЦО_1]. Позвонить ему: [КОНТАКТ_1]».
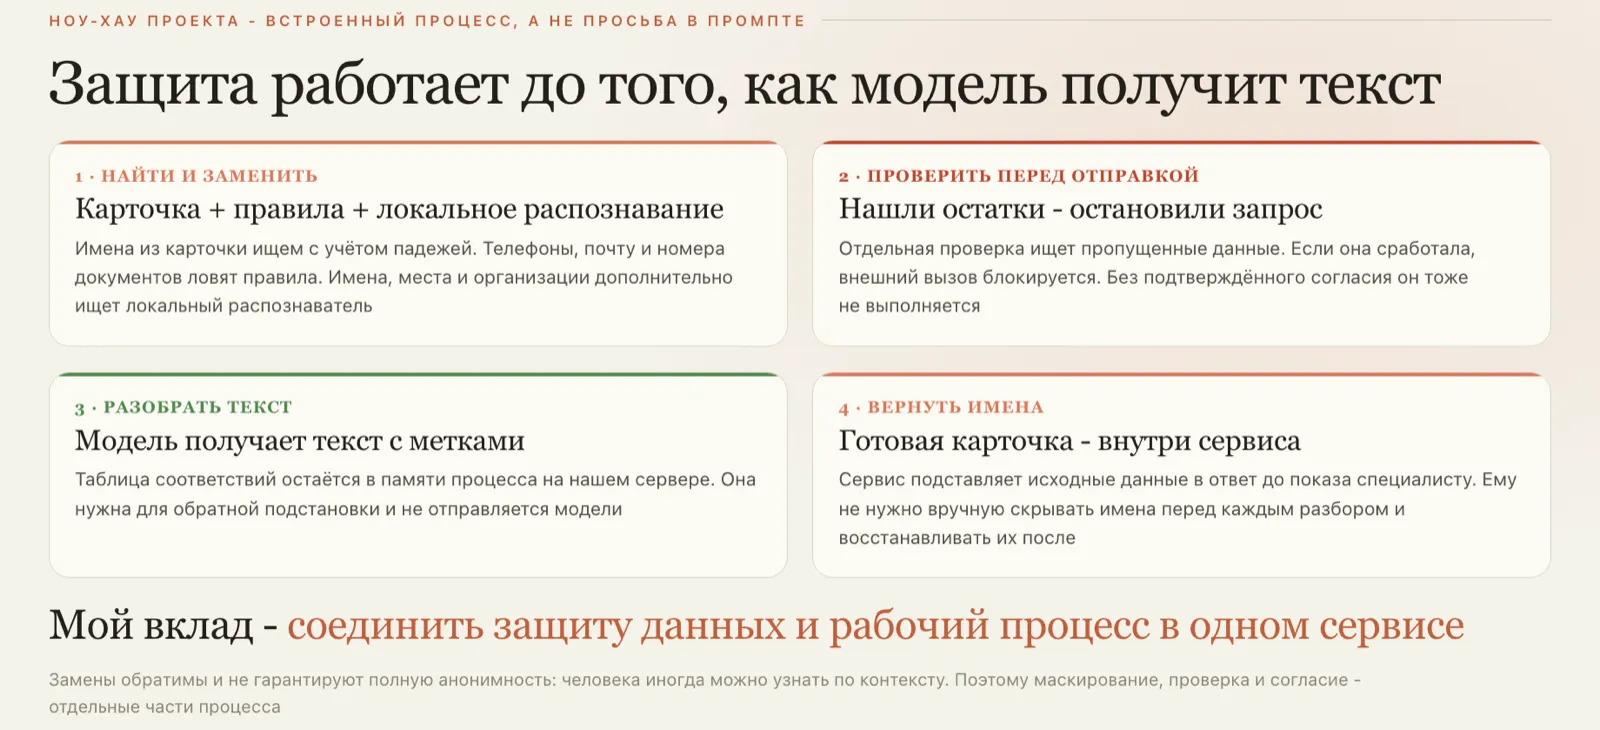
Схема маскирования — слайд из презентации автора, снимок 28.10.2026.
Честные оговорки. На 16 записях проверка не нашла ни одного остатка вида «Фамилия И.», но искажённое написание такой поиск не поймает, поэтому «остатков нет вообще» утверждать не могу. И я сознательно не называю это обезличиванием персональных данных: ключ лежит у нас, связь с человеком восстановима, а иногда человека можно узнать по контексту. Поэтому маскирование, проверка и согласие — три отдельные части процесса, а не одна.
Три вопроса провайдеру до интеграции
- Сохраняете ли вы текст запроса и на какой срок?
- Где физически считается модель?
- Можно ли выключить сохранение и подтверждается ли это документом?
Ответы — письменно. Нет ответа — зафиксируй сам факт запроса: письменный запрос без ответа — уже документ, а не предположение. У одного из провайдеров сохранение запросов оказалось включено по умолчанию. Мы его выключили. Если бы не спросили, не узнали бы никогда.
С чего начать: порядок выбора модели
Если бы я начинал этот проект заново, делал бы так:
- Померить длину текстав токенах, вместе с инструкцией и местом под ответ — минуты
- Сложить вес модели и место под тексти сравнить с доступной памятью и выделенным окном — минуты
- Написать линейку качествачисла и пороги, которые считает код, — в файл с датой, до первого замера; это час
- Прогнать всех на одном живом примереодин промпт, в таблицу — качество, время, цена; кто не дошёл и почему — день
- Слепая вычиткадва-три лучших результата без подписей — тому, кто будет пользоваться; это вечер
- Спросить провайдера про данныетри вопроса письменно — до запуска
Первые два шага отсеивают неподходящие варианты до длинного прогона. Я потратил на это две недели, потому что делал в обратном порядке.
Полный чек-лист выбора модели и 28 правил для ИИ-агента лежат в материалах к разбору — их можно скачать и положить в проект. Ниже — короткая версия под задачу «проверить модель до запуска».
/proverkamodeli [модель]Правила работы с локальными моделями (Ollama, Docker).
1. Перед запуском модели проверь три числа в таком порядке: окно контекста, память в работе, качество. Окно — первым.
2. Посчитай длину входа в токенах: текст + инструкция + место под ответ. Для русского — примерно слова × 2,7. Вход больше окна — модель не подходит, не запускай.
3. Память: вес файла + место под текст сравнивай с доступной памятью (free -m, столбец available), а не со всей. Активно растёт своп — памяти уже не хватает. Реальный расход смотри в docker stats, а не только в ollama ps. Проверь, какое окно контекста выделено при запуске на самом деле, а не только максимум модели.
4. Помни: у многих локальных сборок окно по умолчанию 4096 токенов, и длинный текст режется молча и с начала — вместе с инструкцией. После прогона сверяй число обработанных токенов с отправленным.
5. Пустой ответ — не успех. Считай фрагменты и заполненные поля в ответе, а не код ответа. «Готово, 0 фрагментов» — это сбой.
6. Нехватка памяти выглядит как работа: проверь состояние процесса (ps -o stat; D — ждёт диск) и своп.
7. Не поднимай таймаут вслепую: прогони маленький кусок, замерь время и умножь.
8. Качество оценивает код по линейке, записанной до первого замера, а не сама модель. Не выбирай модель по числу заполненных полей: полноту и опору на источник считай вместе.
9. Не переноси цифры с выдуманного текста на живые данные.
10. В отчёте раздели проверенное и предполагаемое. Не пиши «работает», пока не проверил действием пользователя.Сжато редакцией по правилам Евгения Ганимара (полная версия — 28 правил в материалах к разбору)
Вопросы и ответы
Q1Почему локальная модель возвращает пустой ответ?Кратко: Чаще всего модель не держит заданную форму ответа или текст молча обрезан окном контекста, а конвейер принимает пустой результат за успех.
У gemma3:4b было «готово, 0 фрагментов» пять раз подряд: модель не выдавала список в нужной форме, а код смотрел на статус «успех». Другая причина — окно: во многих сборках оно по умолчанию 4096 токенов, и длинный текст режется с начала вместе с инструкцией. Лечится проверкой в коде: считать содержимое ответа, а не его код, и сверять число обработанных токенов с отправленным.
Q2Какую локальную модель можно запустить на 16 ГБ памяти?Кратко: Ориентир — модели около 7 млрд параметров; модель на 14 млрд с файлом 9 ГБ в работе требует около 12 ГБ и не влезает.
К весу файла прибавляется место под текст: qwen2.5:14b весит 9 ГБ, а в работе занимает около 12 ГБ при 11,8 доступных — и падает с ошибкой 500. Прикинуть заранее можно по учебной формуле: вес × 1,35 плюс 0,12 ГБ на 1000 токенов окна, минус 0,7 ГБ на систему. Окончательный ответ даёт только замер на твоей машине.
Q3Что лучше для распознавания речи: Whisper large-v3-turbo или GigaAM?Кратко: GigaAM v3 в моём замере быстрее в 8,6 раза, но без эталонной расшифровки нельзя сказать, кто точнее, поэтому в бою пока Whisper large-v3-turbo.
На 4-минутном куске large-v3-turbo считал 128 секунд, GigaAM v3 — 15. Но тексты движков разошлись между собой на ~20 %, и это мера различия, а не правоты. Чтобы выбрать, нужна слепая вычитка: одна запись, два текста без подписи, решает тот, кто знает материал.
Q4Как отправить текст с персональными данными в нейросеть?Кратко: Замаскировать имена и контакты до отправки, проверить остатки, блокировать вызов без согласия, а таблицу соответствий держать у себя и подставлять имена обратно.
Имена ищутся с учётом падежей, контакты — правилами, остальное — локальным распознавателем сущностей. Модель получает метки вроде [ЛИЦО_1], ключ к ним не уходит наружу. Маскирование не снимает требований к персональным данным: согласие клиента и ответы провайдера про хранение запросов по-прежнему нужны.
Q5Как понять, что локальная модель не справляется?Кратко: По признакам, а не по её словам: ошибка памяти, переполнение окна, пустой ответ со статусом «успех», состояние процесса D и своп при низкой загрузке процессора.
Ни одна из четырёх моделей не объяснила, что пошло не так: две упали с невнятной ошибкой, две работали вхолостую. Сбой ловится командами: длина входа в токенах до отправки, docker stats и свободная память, счётчик фрагментов в ответе, ps -o stat и free -m. Всё это — минуты, а не часы прогона.
Q6Как выбрать модель под задачу?Кратко: Отсеять по окну и памяти, написать линейку качества до замеров, прогнать всех на одном живом примере и отдать лучших на слепую вычитку.
Сравнивать надо на своей задаче: три модели на одном тексте совпали лишь в одном поле из 30. Цифры линейки отсекают негодное, а выбирает человек, который будет пользоваться результатом. И до интеграции — три письменных вопроса провайдеру про данные.
♥ Промптов в статье: 1 — забирай на полку у каждого или открой все промпты статьи в библиотеке →
// Полезно? Сохрани — так я вижу, что писать дальше. Или отправь коллеге
Сохранённое — на полке, ссылка в шапке сайта.
// Выпуск № 17 «Без розовых очков» хакнут до конца
Ты дошёл до последней статьи номера. Выбери следующий выпуск — какой хакнуть дальше.
 № 19сентябрь 202609.202609.26✕ не хакнутхакнуто ✓ хакнутКоманда из одного11 материалов · 12 нейрохакеров
 № 18июль 202607.202607.26✕ не хакнутхакнуто ✓ хакнутАгенты вместо чатов12 материалов · 13 нейрохакеров
 № 16апрель 202604.202604.26✕ не хакнутхакнуто ✓ хакнутСистема, которая пилит8 материалов · 9 нейрохакеров
 № 15март 202603.202603.26✕ не хакнутхакнуто ✓ хакнутАудитория без бюджета12 материалов · 12 нейрохакеров
 № 14февраль 202602.202602.26✕ не хакнутхакнуто ✓ хакнутСтудия на ноутбуке10 материалов · 11 нейрохакеров
 № 13декабрь 202512.202512.25✕ не хакнутхакнуто ✓ хакнутРутина на автопилоте12 материалов · 13 нейрохакеров
← Галлюцинации нейросети: почему ИИ уверенно ошибается и как это пойматьВесь выпуск № 17 →
// Прочитать с ИИ
Скопируй промпт и вставь в свой ассистент — ChatGPT, Claude, GigaChat, Алису, DeepSeek. Он откроет материал по ссылке, перескажет суть и адаптирует приёмы под твою задачу.
Что в промпте
Разбери материал журнала «Нейрохакер» «Как я 4 раза проиграл локальным LLM-моделям: распознавание речи, замеры, линейка качества и маскирование персональных данных»: https://neyrohacker.com/lokalnye-llm-modeli/

1. Перескажи главную мысль в трёх предложениях.
2. Выпиши приёмы, которые можно применить сразу, — по шагам.
3. Задай мне три вопроса о моей задаче и адаптируй метод под мои ответы.
// Обсудить
Есть вопрос к спикеру или по материалу? Задай его в открытом NeyroCommunity — там обсуждаем доклады саммита, отвечаем на вопросы к спикерам и разбираем материалы журнала.
9 000+ участников в чате сообщества
- вопросы спикерам саммита
- обсуждение докладов и материалов журнала
- общаться и помогать другим
бесплатно · откроется бот в Telegram, он пришлёт приглашение в чат
// Нейрохакер+
Готовые скиллы и нейрогайды под такие задачи
Промпты и скиллы, которые запускаются сразу, и нейрогайды по докладам саммита
Оформить подписку1 990 ₽, далее 990 ₽/месБиблиотека скиллов и нейрогайдов регулярно пополняется.
Подписка с автопродлением. Отменить — в один клик в личном кабинете, без объяснений.
Подписка уже есть? Войти в кабинет →