Галлюцинации нейросети: почему ИИ уверенно ошибается и как это поймать
Нейросеть ответила уверенно, складно и со ссылкой — а верить ли? Разбираем по первоисточникам OpenAI и Anthropic, откуда берутся галлюцинации нейросети, показываем наш тест трёх моделей на пяти ловушках и даём рабочий порядок проверки: второе мнение и сверка всего важного по первоисточнику.
// Интеллект-карта статьи развернуть
Автор — Андрей Плешков
Опубликовано Проверено Чтение ≈ 11 мин
Выпуск № 19 «Команда из одного» · приложение · бонусный хак
// Коротко
- Что получишь
- Определение без мифов; две причины галлюцинаций по исследованию OpenAI; итог нашего теста на пяти ловушках; промпт «второе мнение» с разобранным примером; порядок сверки по первоисточнику.
- Задача
- Как понять, что такое галлюцинации нейросети и почему она уверенно ошибается, и научиться проверять ответы до того, как они уйдут в работу. Материал — всем, кто берёт ответы ChatGPT, Claude и других моделей в работу — в тексты, отчёты, код и решения.
- Ограничения
- Наш тест — 5 вопросов, 3 модели, по одной попытке 22.10.2026: это демонстрация, а не измерение того, как часто модели ошибаются.
- Приём «разреши сказать „не знаю“» описан по документации Anthropic; отделить его эффект наш тест не может — в дополнительном прогоне без этой фразы сменились и модель, и промпт.
- Цифры SimpleQA — из поста OpenAI о их моделях 2025 года; у других моделей и на других задачах картина иная.
Галлюцинации нейросети — это правдоподобные, но ложные утверждения, которые модель выдаёт уверенно: выдуманный факт, несуществующая ссылка, ошибка в рассуждении, поданная как вывод. Формулировка «правдоподобные, но ложные утверждения» взята из исследования OpenAI 2025 года. Откуда они берутся, коротко объясняет Google в правилах для авторов: модель не достаёт факты, а предсказывает вероятную последовательность слов, поэтому может ошибиться. Полностью это не лечится, но ловится — ниже наш тест трёх моделей и порядок проверки, который мы сами используем в редакции.
Что такое галлюцинации нейросети
В быту говорят: «нейросеть врёт». Только врать она не собирается: у неё нет умысла, есть уверенный тон, с которым она выдаёт и правду, и ошибку. Поэтому ошибку не видно по форме ответа — она такая же гладкая, как верный ответ.
Пример из самой OpenAI: широко используемого чат-бота спросили, как называется диссертация Адама Калаи — одного из авторов исследования. Бот уверенно дал три разных названия, и все неверные. На вопрос о дате рождения — три разные даты, тоже все мимо. Вопрос простой, ответ уверенный, результат — ноль.
Галлюцинация — не только выдуманный факт. Это и неверный вывод из верных данных, и устаревшая цифра, поданная как текущая. Ниже увидишь: в нашем маленьком тесте выдумок не нашлось, а в работе редакции попалась именно ошибка в выводе.
Почему возникают галлюцинации ИИ
OpenAI называет две причины, и обе — не баг конкретной модели, а следствие того, как модели учат и оценивают.
Первая — так устроено обучение. На предобучении модель учится предсказывать следующее слово в огромном объёме текста. Меток «правда» и «ложь» у утверждений нет: модель видит только грамотный язык. Закономерности вроде орфографии или парных скобок она с ростом осваивает почти без ошибок. А редкие произвольные факты — чей-то день рождения, название малоизвестной работы — по одним закономерностям не предсказать, и на них модель ошибается.
Вторая — так модели оценивают. Большинство рейтингов считают только точность — долю правильных ответов. Это как тест с вариантами: угадал — может, повезло, оставил пустым — гарантированный ноль. Модели выгоднее угадать, чем сказать «не знаю». OpenAI приводит пример: угадывая день рождения, модель права в одном случае из 365, но на тысячах вопросов угадывающая модель всё равно выглядит в рейтинге лучше осторожной.
Цифры из того же поста — тест SimpleQA из системной карты GPT-5:
| gpt-5-thinking-mini | OpenAI o4-mini | |
|---|---|---|
| Не дала ответа | 52 % | 1 % |
| Верно | 22 % | 24 % |
| Ошибка | 26 % | 75 % |
Старая модель точнее на два пункта — и ошибается почти втрое чаще, потому что почти никогда не говорит «не знаю». Вывод OpenAI: уверенная ошибка хуже честного воздержания.
Отсюда два вывода:
- 100 % точности не будет. На часть вопросов реального мира ответа нет вообще — ни у какой модели, с поиском и без.
- Но галлюцинации не неизбежны. Модель может воздержаться, если не уверена. Чем чаще ты даёшь ей на это право, тем меньше поводов угадывать.
Что показал наш тест 22 октября
Мы взяли пять вопросов-ловушек: выдуманный термин, дословная цитата со ссылкой, свежая цена, точный автор, научные статьи с DOI. Задали их по памяти, без поиска, двум моделям — Claude Sonnet (субагент Claude Code) и Codex (подписка ChatGPT Plus, через CLI ask-codex) — с просьбой оценить уверенность и сказать, если не знают. Дополнительно прогнали тот же набор через Claude Haiku (тоже субагент Claude Code) — без оговорки «скажи, если не знаешь» и без шкалы уверенности. Каждый ответ сверили с первоисточником. Точные версии Sonnet и Haiku в протоколе не записаны, а в выводе нашего запуска Codex версии модели нет — только номер сессии.
| Вопрос-ловушка | Claude Sonnet | Codex | Claude Haiku (дополнительный прогон, без «скажи, если не знаешь») | Первоисточник |
|---|---|---|---|---|
| «Закон Брандолини–Хеймана» (выдуман нами) | не знает, «похоже на выдуманный» | не знает, «возможно, вымышленное» | не знает | термина нет — никто не выдумал |
| Дословная цитата Google об ИИ-контенте и ссылка | воздержался, смысл верный | дал цитату и адрес | цитаты нет, две верные ссылки | цитата и адрес Codex совпали |
| Цена Claude Max | $100 и $200, «на момент запуска» | то же, «актуальность цен на сегодня не подтверждаю» | то же | цена верна; API-кредиты в составе Max, указанные на странице тарифов, в ответах не названы |
| Год и первый автор «Attention Is All You Need» | 2017, Vaswani | 2017, Vaswani | 2017, Vaswani | верно у всех |
| Три статьи 2024 года о галлюцинациях с DOI | отказался | одна статья, про остальные честно «не знаю достаточно точно» | три статьи | все четыре DOI существуют, авторы совпали (одна из статей Haiku — про мультимодальные модели, не только языковые) |
Что из этого честно следует:
- В этих прогонах выдумок не обнаружили. Ни термина, ни цитаты, ни DOI ни одна модель не сочинила. Пять вопросов по одной попытке не говорят о моделях вообще — только о том, что эта демонстрация выдумку не поймала.
- В ответах не перечислены некоторые условия тарифа. Цену Max все назвали верно, но API-кредитов, которые сейчас указаны на странице тарифов, не упомянул никто. Почему — тест не показывает. Модели сами оговорились: Sonnet — «на момент запуска», Codex — «актуальность цен на сегодня не подтверждаю». Такую оговорку легко проскочить глазами.
- Отказ — не то же самое, что верный ответ. В вопросах про цитату и статьи одна модель воздержалась, другая дала сведения, и первоисточник их подтвердил. А там, где модели совпали, совпадение само ничего не доказывало: верность всех ответов мы установили только по первоисточникам.
- Эффект фразы «скажи, если не знаешь» этот тест отделить не может. Haiku без неё тоже не выдумывал, но в дополнительном прогоне сменились сразу и модель, и промпт.
Тест маленький: пять вопросов, три модели, по одной попытке, и модели знали, что это проверка. Это демонстрация, а не замер частоты ошибок.
Случай из редакции: ошибка, которая выглядела как вывод
Показательную ошибку мы поймали не в тесте, а в работе. Claude помогал нам писать методику подготовки статей. Текст вышел связный и убедительный. Перед тем как принять его, мы отдали методику на второе мнение Codex. Вот один из пойманных моментов — как было, что сказал Codex и как стало.
Было. В §1 методики стояла формула «эксперт = расшифровка спикера». По смыслу (пересказ): проверили утверждение по расшифровке выступления — значит, проверено.
Что сказал Codex: «Формула §1 «эксперт = расшифровка спикера» неверна. Расшифровка подтверждает, что человек это сказал; она не подтверждает правильность утверждения и работоспособность метода сегодня».
Как исправили. В §1 теперь: «Расшифровка — не эксперт: она подтверждает, что спикер это сказал, но не что это верно и работает сегодня».
Второй момент — по той же схеме: цифры из чужого кейса Ahrefs в методике читались как норма. Codex: «15 новых и около 30 обновлённых статей в источнике — объём уже выполненной работы, а не установленная норма выпуска». В §1 теперь: «≈15 новых и ≈30 обновлённых у Ahrefs — объём уже сделанной работы, а не норма выпуска».
Ни выдуманных фактов, ни фальшивых ссылок — всё правдоподобно и логично, поэтому такие ошибки легко пропустить: они не выглядят как ошибки. Claude, который писал текст, и Claude, который сводил итог, их пропустили, а вторая модель поймала.
Как бороться с галлюцинациями нейросети: пять приёмов
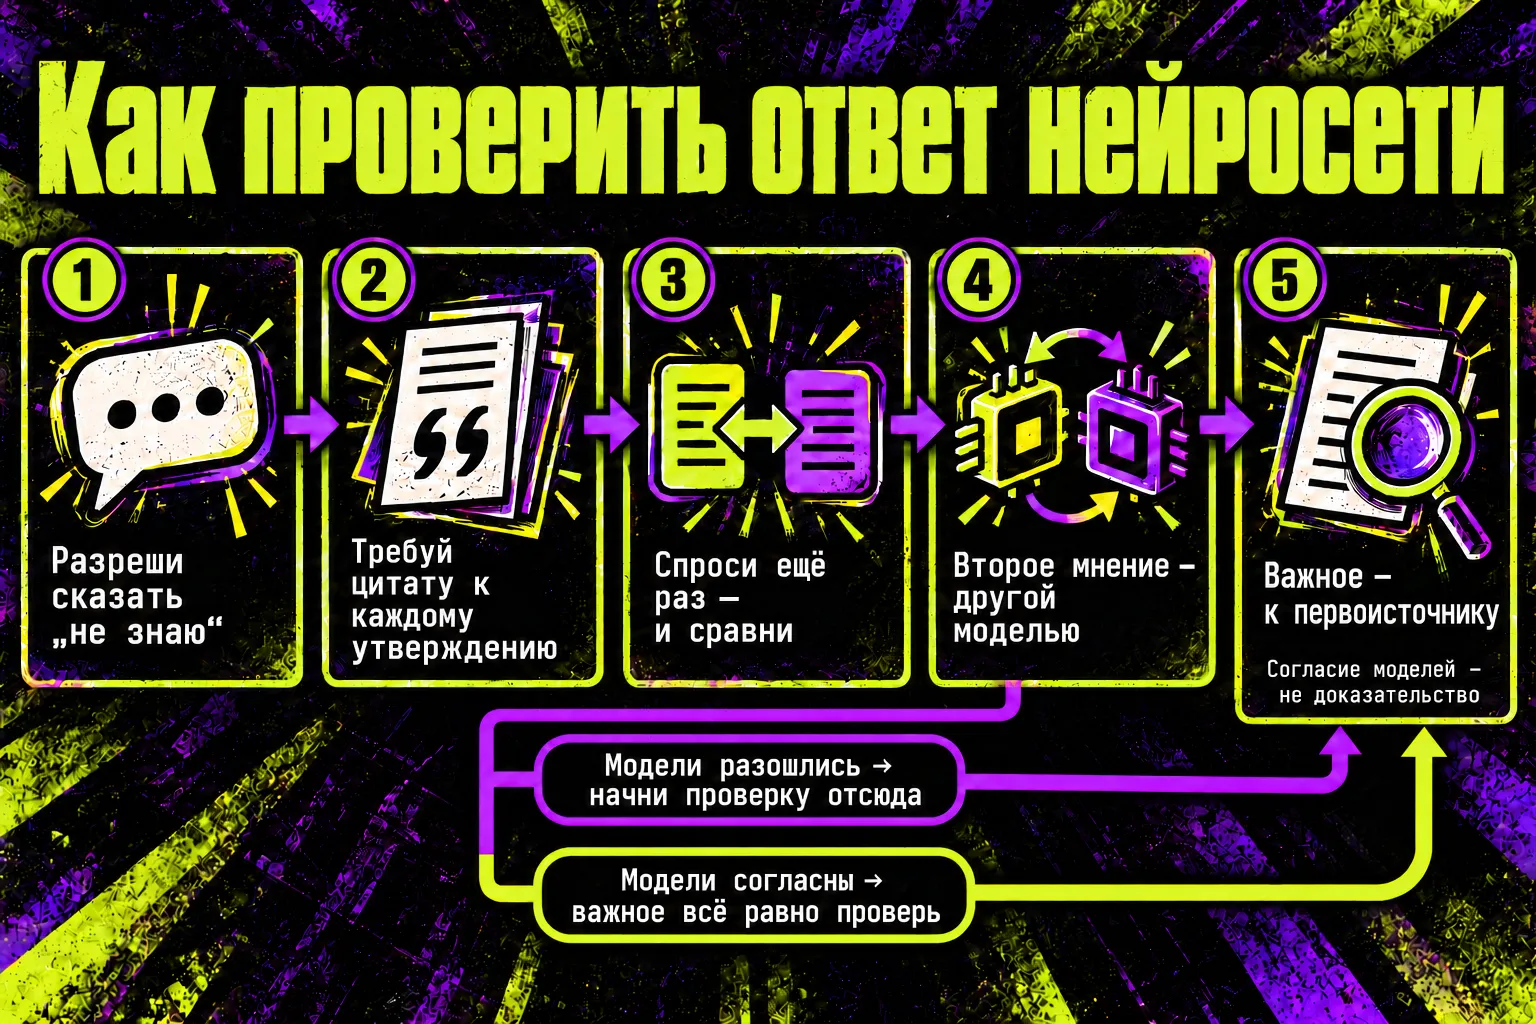
От самого дешёвого к самому надёжному. Первые три — из документации Anthropic по снижению галлюцинаций, последние два — наша практика. Общее правило для всех пяти: важное утверждение — цифру, цену, цитату, вывод, на который опираешься, — проверяешь по первоисточнику, даже если модели согласны и уверены. Согласие и расхождения только подсказывают, с чего начать.
1. Разреши сказать «не знаю»
Прямо напиши в промпте: «Если не знаешь или не уверен — так и скажи». Anthropic пишет, что это может резко сократить ложную информацию. Честно: отделить эффект этой фразы наш тест не может. Но фраза ничего не стоит, а OpenAI прямо пишет: галлюцинации не неизбежны, потому что модель может воздержаться, когда не уверена.
2. Требуй цитату к каждому утверждению
Попроси модель к каждому утверждению привести дословную цитату и источник. А после ответа — пройтись по утверждениям ещё раз: не нашла подтверждающую цитату — пусть снимет утверждение. Сам тоже проверь: открой ссылку, найди цитату на странице и посмотри, подтверждает ли она именно это утверждение, а не что-то рядом. Для длинных документов Anthropic советует начинать с выписки цитат и только потом делать задачу. Если работаешь со своими материалами, добавь «отвечай только по этим документам, не из общих знаний» — на этом принципе построен метод в нашем разборе исследования рынка в NotebookLM и Perplexity.
3. Спроси ещё раз — и сравни
Anthropic называет это Best-of-N: прогони один и тот же промпт несколько раз и сравни ответы. Несовпадения между ними — признак возможной галлюцинации. Совпадение же — не доказательство: важное всё равно сверяй с источником.
4. Второе мнение — другой моделью
Наш шаг дальше: не та же модель второй раз, а другая. Так мы поймали ошибки в методике. Удобнее всего отдать второй модели не вопрос, а уже готовый ответ первой — на проверку. Её отметка «уверен, что верно» — не доказательство, а подсказка, что проверять первым. Держать под рукой запасную модель полезно и так — об этом наш разбор как выбрать нейросеть под задачу.
/vtoroe [текст на проверку]Подставь своё 2 поля
Ты — придирчивый фактчекер. Ниже вопрос и ответ другой нейросети. Твоя задача — не переписать ответ, а найти в нём то, что может быть неправдой.

Вопрос: [вопрос]

Ответ на проверку:
[ответ]

Сделай так:
1. Разбей ответ на отдельные утверждения: факты, цифры, даты, цены, имена, ссылки, цитаты и выводы.
2. По каждому утверждению поставь отметку: «уверен, что верно», «сомневаюсь», «вероятно неверно», «не могу проверить без источника». Отдельно отметь то, что могло устареть: цены, тарифы, версии, правила. Помни: твоя отметка «уверен» — оценка, а не доказательство; всё важное я всё равно сверю с источником.
3. Особо проверь выводы: следует ли вывод из того, что сказано выше, или это только звучит логично.
4. Для каждого «сомневаюсь» и «вероятно неверно» объясни, почему. Для каждого важного утверждения — с любой отметкой — скажи, где его проверить: какой первоисточник (официальный сайт, документация, оригинал статьи).
5. Если чего-то не знаешь — так и скажи. Не придумывай источники и ссылки: лучше «не знаю, где проверить», чем выдуманный адрес.

В конце — короткий список: что проверить в первую очередь.Промпт редакции. Вставляй во вторую модель — не в ту, что писала ответ.
Как выглядит проверка на деле — пример из нашего теста, вопрос про цитату Google:
- Утверждение. Codex: «Appropriate use of AI or automation is not against our guidelines.» — со ссылкой на https://developers.google.com/search/blog/2023/02/google-search-and-ai-content.
- Сомнение. Сам Codex оговорился: «Без проверки не гарантирую дословность». Claude Sonnet на тот же вопрос дословную цитату давать не стал.
- Первоисточник. Открываем страницу блога Google Search от февраля 2023 года и ищем фразу: «Appropriate use of AI or automation is not against our guidelines.» — она там есть дословно и говорит ровно то, ради чего её цитируют: уместное использование ИИ правилам не противоречит.
- Исправление. Не понадобилось: цитата и адрес верны. Не найдись фразы на странице — цитату убрали бы или заменили формулировкой со страницы.
5. Важное — к первоисточнику, даже если модели согласны
Это главный шаг, и его не заменит никакая модель. Всё, на что опираешься, сверяй с оригиналом: официальный сайт — для цен и тарифов, документация — для функций, сама статья — для цитаты, DOI — для научной ссылки. Расхождение между моделями — не повод выбрать ту, что звучит увереннее, а место, откуда начать. Совпадение — не повод пропустить. В нашем тесте верность ответов — и разошедшихся, и совпавших — установили только так.
Отдельно — всё, что меняется: цены, тарифы, версии, законы. Здесь даже верный ответ модели может описывать прошлое состояние. Оговорки модели вроде «на момент запуска» читай как «проверь на сайте».
Есть и готовые инструменты для второго мнения — расширения браузера, которые отправляют один промпт сразу во много чатов и показывают ответы рядом. Помни цену удобства: такие расширения работают через твои аккаунты и могут видеть переписку. Прежде чем ставить, реши, готов ли ты это доверить.
Для тех, кто публикует. Google не запрещает ИИ-контент — ещё в 2023 году он написал, что уместное использование ИИ правилам не противоречит, — но перед публикацией советует вручную проверить факты и вычитать весь ИИ-текст на точность. Вторая модель эту проверку не заменяет, а подсказывает, с чего её начать.
С чего начать
- Добавь в промпт «скажи, если не знаешь»Одна фраза — и у модели появляется право не угадывать.
- Проси цитату и источник к каждому утверждениюОткрой ссылку, найди цитату и проверь, подтверждает ли она именно это утверждение. Нет подтверждения — утверждение снимается.
- Отдай ответ второй модели на проверкуПромпт «Второе мнение» выше — во вторую модель, не в ту, что писала. Её «уверен» — подсказка, а не доказательство.
- Важное — к первоисточникуЦифры, цены, цитаты, выводы — по официальному сайту, документации, оригиналу статьи или DOI, даже если модели согласны. Расхождения подсказывают, с чего начать.
- Цены, тарифы, версии — только с сайтаОговорки вроде «на момент запуска» читай как «проверь сегодня».
Вопросы и ответы
Q1Что такое галлюцинации нейросети?Кратко: Правдоподобные и уверенные, но неверные ответы модели: выдуманный факт, несуществующая ссылка, устаревшая цифра или ошибочный вывод.
Механизм объясняют OpenAI и Google: модель не достаёт факты, а предсказывает вероятное продолжение текста, поэтому может уверенно выдать неправду. По форме ошибку не отличить от верного ответа — тон тот же.
Q2Почему нейросеть врёт?Кратко: Умысла нет: редкие факты не предсказать по закономерностям языка, а обучение и рейтинги поощряют угадывать, а не говорить «не знаю».
По исследованию OpenAI, причин две. На предобучении модель видит только грамотный текст без меток «правда / ложь», а редкие произвольные факты — даты, названия, имена — по одним закономерностям не предсказать, и на них модель ошибается. А при оценке большинство тестов считают только долю правильных ответов: угадать выгоднее, чем честно воздержаться. Отсюда уверенный тон даже там, где модель не знает.
Q3Как проверить ответ нейросети?Кратко: Попроси источники к каждому утверждению, отдай ответ второй модели на проверку и всё важное сверь с первоисточником — даже если модели согласны.
Рабочий порядок: в промпте разреши сказать «не знаю» и попроси цитату к каждому утверждению; готовый ответ отдай другой модели с промптом «Второе мнение»; всё важное и всё, что меняется со временем (цены, тарифы, версии), проверь на официальном сайте или в оригинале. Расхождения между моделями подсказывают, с чего начать, а согласие моделей и их уверенный тон — не доказательство.
Q4Можно ли избавиться от галлюцинаций полностью?Кратко: Нет: 100 % точности не будет ни у одной модели, но частоту уверенных ошибок можно сильно снизить.
OpenAI прямо пишет, что точность никогда не достигнет 100 %: на часть вопросов ответа нет вообще. При этом галлюцинации не неизбежны — модель может воздержаться, когда не уверена. Anthropic добавляет, что приёмы снижения галлюцинаций помогают, но не устраняют их полностью, поэтому критичную информацию нужно проверять всегда.
Q5Какие ответы нейросети проверять в первую очередь?Кратко: Свежие цены и тарифы, точные цитаты и ссылки, редкие факты о людях и выводы, на которые ты опираешься в решении.
В нашем тесте модели не выдумали ни одного факта, но в ответах о тарифе Claude Max не были перечислены некоторые его условия — поэтому цены и тарифы всё равно смотри на сайте. По OpenAI, ошибается модель на редких произвольных фактах: даты, названия, имена. А по нашему опыту в редакции, ошибки в выводах легко пропустить: они звучат логично, и их не ищешь.
♥ Промптов в статье: 1 — забирай на полку у каждого или открой все промпты статьи в библиотеке →
// Полезно? Сохрани — так я вижу, что писать дальше. Или отправь коллеге
Сохранённое — на полке, ссылка в шапке сайта.
// Выпуск № 19 «Команда из одного» хакнут до конца
Ты дошёл до последней статьи номера. Выбери следующий выпуск — какой хакнуть дальше.
 № 18июль 202607.202607.26✕ не хакнутхакнуто ✓ хакнутАгенты вместо чатов12 материалов · 13 нейрохакеров
 № 17май 202605.202605.26✕ не хакнутхакнуто ✓ хакнутБез розовых очков12 материалов · 12 нейрохакеров
 № 16апрель 202604.202604.26✕ не хакнутхакнуто ✓ хакнутСистема, которая пилит8 материалов · 8 нейрохакеров
← Как пользоваться Claude в России через API: Polza.ai и другие провайдеры без VPNВесь выпуск № 19 →
// Прочитать с ИИ
Скопируй промпт и вставь в свой ассистент — ChatGPT, Claude, GigaChat, Алису, DeepSeek. Он откроет материал по ссылке, перескажет суть и адаптирует приёмы под твою задачу.
Что в промпте
Разбери материал журнала «Нейрохакер» «Галлюцинации нейросети: почему ИИ уверенно ошибается и как это поймать»: https://neyrohacker.com/gallyucinacii-neyroseti/

1. Перескажи главную мысль в трёх предложениях.
2. Выпиши приёмы, которые можно применить сразу, — по шагам.
3. Задай мне три вопроса о моей задаче и адаптируй метод под мои ответы.
// Обсудить
Есть вопрос к спикеру или по материалу? Задай его в открытом NeyroCommunity — там обсуждаем доклады саммита, отвечаем на вопросы к спикерам и разбираем материалы журнала.
9 000+ участников в чате сообщества
- вопросы спикерам саммита
- обсуждение докладов и материалов журнала
- общаться и помогать другим
бесплатно · откроется бот в Telegram, он пришлёт приглашение в чат
// Нейрохакер+
Готовые скиллы и нейрогайды под такие задачи
Промпты и скиллы, которые запускаются сразу, и нейрогайды по докладам саммита
Оформить подписку1 990 ₽, далее 990 ₽/месБиблиотека скиллов и нейрогайдов регулярно пополняется.
Подписка с автопродлением. Отменить — в один клик в личном кабинете, без объяснений.
Подписка уже есть? Войти в кабинет →