GEO-оптимизация сайта конвейером субагентов: одна новость — одна страница без ручных «продолжить?»
GEO-оптимизация — подготовка страниц к тому, чтобы на них опирались ответы нейросетей в поиске. Артур Хорошев ставит её на конвейер: по его замыслу плагин Cursor из одиннадцати субагентов по одной новости сам собирает ключи, пишет лонгрид, верстает, публикует и проверяет страницу. На эфире прогон зависал, и готовую страницу не показали, — поэтому отделяем рассказанное от показанного и даём реконструкцию для повторения. Разбираем, как устроен конвейер, почему агенты в нём не спрашивают «продолжить?», какие приёмы работают открыто, а какие грозят санкциями, — и где без человека нельзя.
// Интеллект-карта статьи развернуть
🎧 Саундтрек статьи
По выступлению Артура Хорошева на NeyroSummit 16Редактор — Андрей Плешков
Опубликовано Проверено Чтение ≈ 17 мин
Версии моделей, сервисов и цены — на дату выступления,
Выпуск № 16 «Система, которая пилит» · Генеративный контент · 7 из 8
// Коротко
- Что получишь
- Схема ролей и порядка запуска, шаблон файла субагента и правило «не спрашивай — проверяй себя», список открытых GEO-приёмов и запретов, понимание, где в конвейере обязателен человек.
- Задача
- Как собрать конвейер ИИ-субагентов, который готовит страницы сайта под поиск и ответы нейросетей — от семантического ядра до проверки опубликованной страницы — и не нарваться на санкции поисковиков. Материал — тем, у кого есть свой сайт или блог и кто уже работает в Cursor, Claude Code или Codex и хочет поставить подготовку страниц на конвейер.
- Ограничения
- Сам плагин спикера и промпты его агентов публично не выложены: шаблон роли и правила в статье — реконструкция редакции по описанию на докладе.
- На эфире прогон дважды зависал, итоговая страница к концу доклада была недоделана, обещанный живой SEO-аудит не показан.
- Модели, тарифы и устройство плагинов Cursor — на 16.04.2026, по словам спикера; к октябрю многое изменилось — смотри «Дополнения редакции».
- Цифры трафика, удержания и стоимости — оценки спикера, на экране без проверяемых данных. Автопубликация без человека — его позиция, а не совет редакции.
Зачем сайту GEO, если есть SEO
Быстрые ответы Яндекса, обзоры Google, чаты вроде ChatGPT собирают ответ из чужих страниц — и сайту выгодно оказаться среди них. Артур Хорошев, автор канала «Ковчег», на NeyroSummit 16 объяснял это так: помимо обычной выдачи теперь нужно «рекламироваться в выдачах нейросетей», и под это есть отдельный набор приёмов. Самый простой — быстрый ответ в первом блоке: если статья про Cursor, первая фраза должна сразу говорить, что такое Cursor.
Сам доклад был не про теорию GEO, а про то, как поставить подготовку таких страниц на конвейер. Артур увлекается трафиком и показывал один кейс: по его описанию, по одной новости плагин Cursor из одиннадцати субагентов сам собирает семантическое ядро, ищет источники, пишет лонгрид, вставляет рекламные блоки, анимирует первый экран, верстает, публикует и проверяет страницу. Вручную, по его словам, такой лонгрид с визуалом занимает от пары часов до дня, конвейером — 20–40 минут.
Почему лонгрид: это большая страница, которая раскрывает тему полностью, и поисковые системы, по словам Артура, такие страницы «очень любят». Ниже — метод по шагам и разбор, какие GEO-приёмы из доклада работают открыто, а каких делать нельзя.
Что важно знать сразу. На эфире прогон дважды зависал, и к концу доклада итоговая страница была недоделана, а обещанный живой аудит не показан. Устройство конвейера и роли — со слов Артура и с его экрана; файлы ролей, правило директора и чек-лист аудита — реконструкция редакции. Рост трафика его сайта — оценка спикера, и по этим данным нельзя сказать, какая часть роста пришлась именно на GEO.
Почему один агент не доводит страницу до конца
Если попросить агента «собери страницу по такой-то новости», он, скорее всего, сделает кусок и спросит: «Я закончил текст. Позвать следующего, чтобы вставить рекламу?» Артур оценивает это примерно в 70 % случаев. Каждый такой вопрос — остановка, и «офис, который работает без одобрений, исправлений и вмешательства человека», как он сформулировал цель доклада, не получается.
Вторая проблема — цена. Прогон одной страницы у Артура длится около 20 минут и тратит около миллиона токенов. По его прикидке, тот же прогон на OpenClaw обошёлся бы «баксов в 20», потому что каждый агент перечитывает весь контекст, а в Claude Code — тоже дорого. Поэтому он гоняет конвейер на дешёвой модели внутри подписки, а точность добирает правилами и проверками.
Третья — контекст. Одна модель, которая и ищет ключи, и пишет текст, и верстает, держит в голове всё сразу и начинает терять детали. Отдельный субагент получает только свою часть и возвращает только итог. Как в целом выбирать между правилами, скиллами и субагентами, мы разбирали по докладам того же сезона: правила, скиллы или субагенты — что выбрать.
Плагин Cursor: агенты, правила, команды и MCP в одной упаковке
Конвейер Артура живёт в плагине Cursor. Он называет плагин экосистемой, где «всё смешано и работает в своей атмосфере»: субагенты, правила, команды, хуки, MCP-серверы. На 16.04.2026, по словам спикера, внутри его плагина было:
- 11 субагентов с ролями (на слайде — 10, одного он добавил позже) и директор;
- 4 правила — кто за кем идёт и кто за что отвечает;
- команды для директора — чтобы перезапустить одного агента, если он сделал что-то не так;
- MCP-инструменты у тех агентов, которым они нужны: подбор ключей, публикация, проверка.
Плагин установлен локально и, по словам Артура, публиковать его не обязательно. Запускать можно по задаче, по расписанию (например, в 9 утра и в 8 вечера) или командой из Telegram; можно держать в облаке. На эфире он показывал локальный запуск: вставил в чат Cursor короткую новость и написал «с помощью плагина и субагентов создай страницу сайта».
Мультиагентная система ИИ на одну страницу: роли по порядку
Мультиагентные системы ИИ обычно описывают абстрактно — «оркестратор и исполнители». У Артура это конкретная цепочка с человеческими именами: так проще помнить, кто за что отвечает, и проще перезапустить одного. Вот порядок, который он показал (на 16.04.2026):
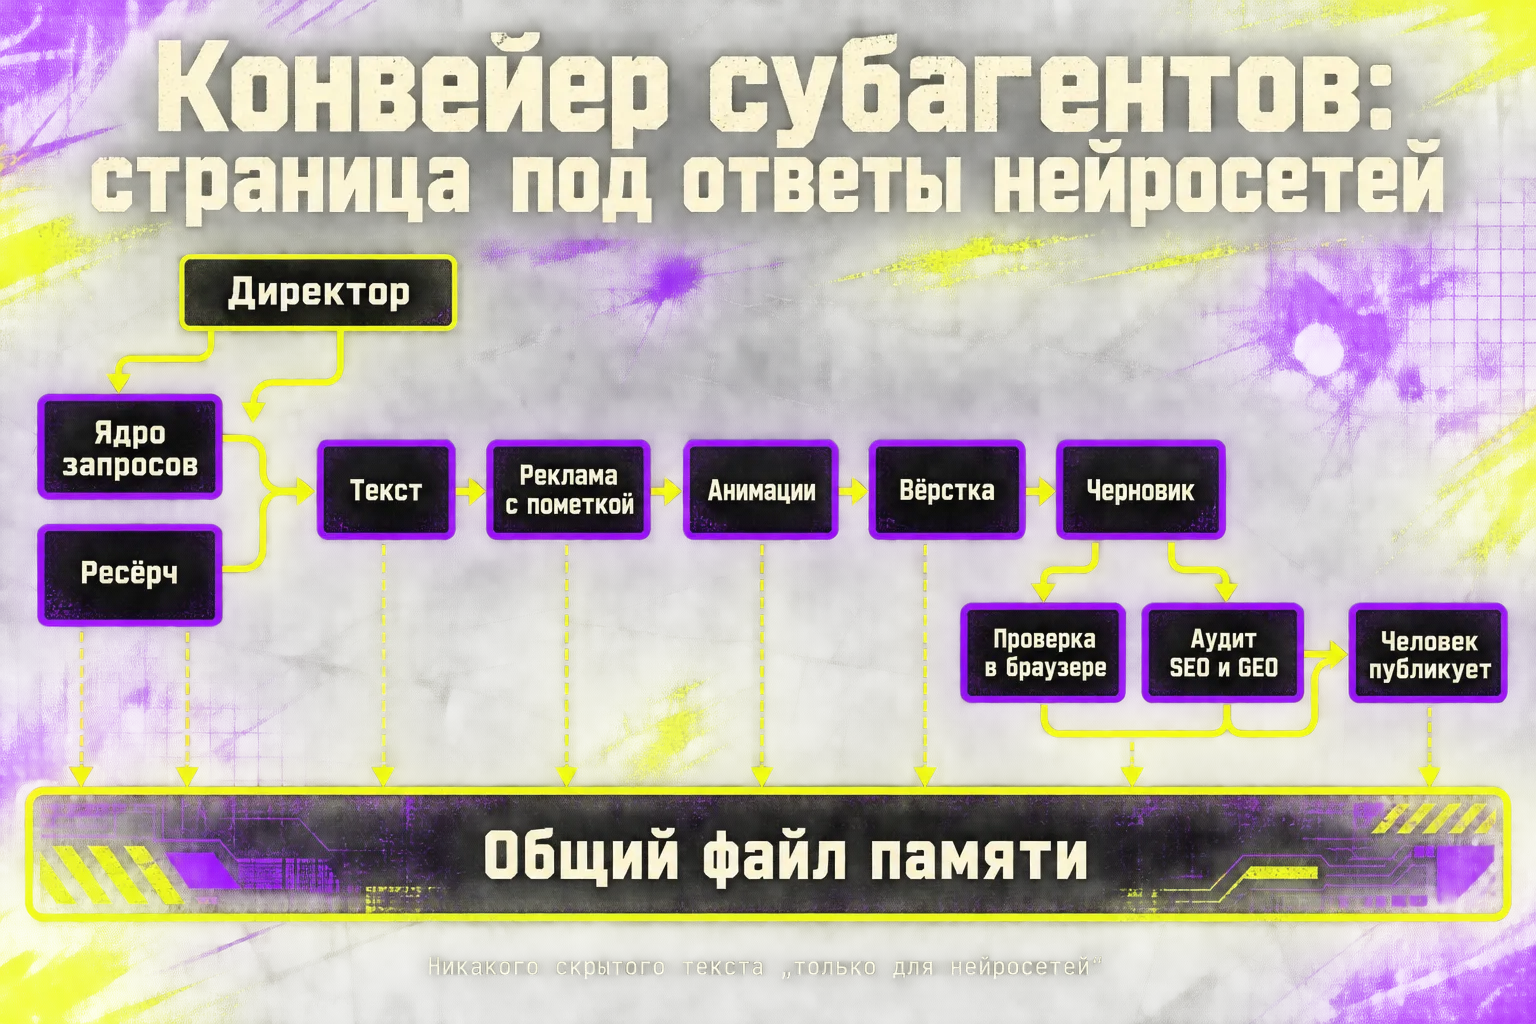
- Директор — распределяет задачи, объясняет каждому, что делать и кто за кем идёт.
- Коля — семантическое ядро: через MCP с Wordstat собирает фразы, по которым люди ищут тему. На демо — 10 запросов, в работе — 50.
- Артём — ресёрч: новости по теме, код на GitHub, источники. Коля и Артём работают параллельно.
- Женя — текст лонгрида по ядру, от 8 до 20 тысяч знаков в зависимости от глубины темы, по правилам SEO и GEO.
- Артур — размечает текст и вставляет рекламные блоки туда, где они «по формату зайдут»: у спикера — свой канал и баннер хостинга.
- Алина — анимация первого экрана (hero-блока); Борис — лёгкая анимация в середине страницы. Работают вместе. Анимации — особенность его страниц, а не требование GEO.
- Наташа — собирает всё в код страницы.
- Юра — публикует страницу на хостинг по FTP.
- Макс — открывает опубликованную страницу в браузере, делает скриншоты, смотрит код: не поехали ли блоки.
- Лёня — аудит SEO и GEO: краулер забирает код страницы и проверяет по чек-листу. Макс и Лёня работают параллельно.
Поток целиком: ядро и ресёрч параллельно → текст → реклама и анимации → вёрстка → проверки (браузер и аудит параллельно) → если проверка не прошла, шаг возвращается на исправление → у Артура дальше публикация, у нас — черновик и человек.
Свой MCP-сервер Артура для ядра (Wordstat, WordPress, автопостинг) — его личный инструмент; для повторения подойдёт любой доступ к статистике запросов через MCP или API. Если ставишь задачу каждой роли, формулируй её от результата, а не от действия — так, как разбирали в методе «от конца» для задач агентам.
Шаблон роли на эфире не показывали. Ниже — реконструкция в формате файла субагента Cursor:
/georole [роль]---
name: zhenya-copywriter
description: Пишет текст лонгрида по семантическому ядру и ресёрчу. Зови после того, как в файле памяти есть разделы «Ядро» и «Ресёрч».
---
Ты — копирайтер конвейера страниц. Одна задача: текст лонгрида.
Вход: файл памяти handoff.md — разделы «Ядро» (ключевые фразы) и «Ресёрч» (факты со ссылками на источники).
Задача:
- объём от 8 до 20 тысяч знаков, по глубине темы;
- первый абзац — прямой ответ на главный запрос: для запроса «что такое» — «X — это…», для инструкции — сразу результат или первый шаг;
- заголовки разделов отвечают на вопросы читателя, ключевые фразы — по смыслу, без переспама;
- каждый факт и цифра — только из раздела «Ресёрч», со ссылкой; чего нет в источниках — не пиши;
- в конце — блок «Вопросы и ответы», 5–7 вопросов из ядра, ответы видимым текстом.
Запрещено: скрытый текст, текст «только для роботов», выдуманные цифры и цитаты.
Готово, когда: текст записан в раздел «Текст» файла handoff.md и ты сам сверил по списку выше каждый пункт. Не спрашивай человека, продолжать ли, — запиши итог и верни директору одну строку: «Текст готов, N знаков, проверка пройдена» или «Не готово: причина».Реконструкция по методологии спикера: на докладе описаны роли и правила, сами файлы не показаны
Общий файл памяти и порядок: что параллельно, а что цепочкой
Агенты у Артура не передают друг другу результаты «на словах». Есть один общий файл — он называет его общим блоком памяти, — куда каждый пишет свою часть и откуда следующий читает предыдущую. На эфире в файле уже лежали ядро с частотами запросов от Коли и структура с «уникальным углом» от Артёма.
У общего файла есть приятный побочный эффект, который случайно показал эфир: после перезапуска Cursor конвейер продолжил не с начала, а с Жени — ядро и ресёрч уже были в файле. Прогон можно оборвать и продолжить с того места, где остановился, — если у каждого раздела в файле есть статус «готово / не готово» и пометка, к какой задаче он относится. Иначе директор примет вчерашний раздел за сегодняшний.
Одна оговорка редакции: если два агента одновременно правят один файл, один может затереть запись другого. Надёжнее, когда параллельные агенты пишут каждый в свой раздел или свой файл (results/kolya.md, results/artem.md), а сводит их директор.
Правило параллельности у Артура простое: параллельно — только то, что не зависит друг от друга. Ядро и ресёрч не нужны друг другу — их собирают одновременно. Текст без ядра не напишешь — Женя ждёт. Лонгрид поэтому в основном цепочка. А для многоблочного сайта Артур сделал отдельный плагин: главный агент делает дизайн всего сайта и параллельно запускает около десяти субагентов — каждый собирает свой блок (вопросы и ответы, информация, товары), потом идут верстальщик и проверяющие.
Второе правило — не спрашивать, а проверять себя. Ради него, по словам Артура, всё и затевалось: агенты не должны спрашивать, продолжать ли, они должны работать и проверять свою работу. Так можно записать правило директора:
/nonstop [задача]Ты — директор конвейера страниц. Ты не пишешь текст и код сам, ты запускаешь субагентов и следишь за порядком.
Порядок:
1. Параллельно: ядро (kolya-keywords) и ресёрч (artem-research).
2. Текст (zhenya-copywriter) — после того, как в handoff.md есть «Ядро» и «Ресёрч».
3. Блоки и анимации — после текста.
4. Вёрстка — после всех блоков.
5. Проверки: браузер (max-qa) и SEO/GEO-аудит (lenya-audit) — параллельно.
Правила:
- Не спрашивай человека «продолжить?» и «позвать следующего?». Каждый субагент сам проверяет свой итог по своим критериям и пишет его в handoff.md.
- Перед запуском следующего прочитай handoff.md: если раздела предыдущего шага нет или в нём «Не готово» — перезапусти этот шаг один раз с причиной. Второй отказ — остановись и опиши проблему.
- Параллельные шаги пишут каждый в свой файл results/<роль>.md; в handoff.md их сводишь ты.
- Не начинай с начала, если часть разделов уже есть в handoff.md: продолжай с первого, где нет статуса «готово» для этой задачи. Если шаг переделан — перезапусти и все шаги после него.
- Публикацию не делай сам: в конце положи готовую страницу в черновики и верни человеку сводку проверок.Реконструкция по методологии спикера
Оптимизация сайта под ИИ и нейросети: что работает открыто, а что — клоакинг
В правилах Жени у Артура были открытые GEO-приёмы: быстрый ответ в первом блоке, разметка вопросов и ответов, служебные файлы, где сайт объясняет нейросетям, что на странице. Но прозвучало и такое: этот код «может быть скрытым от человека, и он работает только с нейросетями».
Этого не делай. Показывать роботам одно, а людям другое — клоакинг, а текст, который спрятан от людей ради ранжирования, — скрытый текст. И Google, и Яндекс относят это к нарушениям. Граница — не в том, видна ли каждая строка кода: служебная разметка, раскрывающиеся блоки, подписи для скринридеров — нормальная практика. Нарушение — прятать или подменять содержание, чтобы робот получил не то, что человек.
Что можно делать открыто:
- Быстрый ответ. Первая фраза страницы отвечает на главный запрос: на «что такое» — определением «X — это…», на «как сделать» — результатом или первым шагом.
- Честная структура. Заголовки отвечают на вопросы читателя, факты — со ссылками на источники, в конце — вопросы и ответы видимым текстом.
- Разметка — только из видимого текста. Если размечаешь вопросы и ответы, они должны быть на странице для людей.
- Файл llms.txt — путеводитель по сайту для ИИ-агентов в корне сайта. Сделать его недолго, но доказанной пользы нет — ни в кейсе Артура, ни у поисковиков: это предложение сообщества, а не их требование (подробности ниже).
- Обычное SEO. Нейросети поиска опираются на страницы, которые и так высоко в выдаче.
Последний агент конвейера, Лёня, у Артура проверял страницу по SEO/GEO-чек-листу. Его чек-лист и краулер не выложены, поэтому вот открытая версия аудита — её можно дать субагенту или просто вставить в чат с кодом страницы:
/geoaudit [адрес страницы]Проверь страницу по адресу или по её коду. Отвечай таблицей «пункт | есть / нет / не проверено | доказательство | что исправить».
Доказательство — цитата из кода или текста, скриншот, ссылка. Если проверить нечем (например, по одному HTML не видно, как страница выглядит на телефоне), ставь «не проверено» и пиши, чем проверить.
1. Первый абзац прямо отвечает на главный запрос страницы (для определения — «X — это…», для инструкции — результат или первый шаг).
2. Один H1, заголовки H2/H3 отвечают на вопросы читателя, без переспама ключами.
3. Каждый факт и цифра — со ссылкой на источник; нет утверждений без источника.
4. Есть блок «Вопросы и ответы» видимым текстом.
5. Структурированные данные (если есть) совпадают с видимым текстом страницы.
6. Нет скрытого текста и подмены: содержание для робота и для человека одно и то же. Служебная разметка, раскрывающиеся блоки и подписи для скринридеров — не нарушение.
7. Указан автор или редакция и дата обновления.
8. Страница открывается без ошибок на телефоне, блоки не съезжают, анимации не мешают читать.
9. Реклама на странице помечена как реклама.
10. Страница даёт что-то своё: опыт, пример, данные — а не пересказ чужих текстов.
В конце — три самые важные правки по порядку.Реконструкция по методологии спикера: чек-лист составлен редакцией по открытым правилам Google и Яндекса
Сколько стоит прогон: дешёвая модель и проверки
На 16.04.2026 Артур выбирал модели так (это его субъективная оценка): дизайн и тексты — Gemini 3.1 Pro, код — GPT-5.4, а «если про деньги» — Composer, собственная модель Cursor, которую он описывал как Kimi 2.5, переобученную Cursor. Composer, по его словам, входит в подписку и стоит «сущие копейки», поэтому весь конвейер он гоняет на нём. Сама анимированная презентация доклада, по его словам, тоже сделана в Cursor на этой модели.
Плата за дешёвую модель — внимательность. Артур прямо говорит: такая модель «очень шустрая» и «упускает очень много деталей». Но если выстроить алгоритм точечно и с проверками, она, по его опыту, даёт хороший результат без лишних денег.
Доступность моделей в Cursor из России меняется: на эфире у спикера были сбои, а в чате зала долго спорили, какие модели работают. Сверяй на сегодня; как подключить Claude легально, мы разбирали отдельно — Claude в России через API.
Генерация страниц и человек: где конвейер не заменяет редактора
Свой результат Артур показывал на сайте-прокладке на WordPress, через который он автоматизирует публикацию в блог на Дзене (прямого API у Дзена, по его словам на апрель 2026 года, не было). По его словам, после доработки под SEO и GEO трафик заметно вырос, Яндекс присвоил сайту показатель качества (в речи — «ТИЦ», сейчас в Вебмастере вместо него ИКС), удержание выросло «от 20 секунд» до минут. Весь сайт, по его словам, Cursor оптимизировал за 2 часа. Метрика была на экране, проверяемых цифр в речи нет — это оценки спикера. Планы — «штук 10» страниц в день; за пару дней он создал около 20, и «некоторые уже приносят результат», хотя SEO и GEO, как он сам оговаривается, работают на долгой дистанции.
Зал спорил: «больше половины контента — уже нейрослоп». Ответ Артура — статистика за него, а альтернатива — нанять трёх маркетологов и дизайнера за 300 тысяч в месяц. Позиция журнала здесь другая, и она совпадает с тем, что пишут сами поисковики: массовая генерация страниц без пользы для людей — нарушение, а ИИ-текст без своей ценности не ценен (см. дополнение выше). Поэтому метод мы предлагаем так:
- Конвейер готовит черновики, человек читает и публикует. Последнее слово директора — «положи в черновики», а не «опубликуй».
- Каждой странице — своё: опыт, пример, данные, которых нет у других. Пересказ десяти чужих новостей нейросети и поисковику не нужен.
- Объём — по спросу, а не «10 в день» ради числа.
- Реклама — с маркировкой. Агент Артура сам вставлял баннер партнёра. В России реклама в интернете должна быть помечена словом «реклама» и указывать рекламодателя (или сайт со сведениями о нём), а распространять её можно только после того, как оператор рекламных данных присвоит ей идентификатор — тот самый erid (ч. 16–17 ст. 18.1 закона № 38-ФЗ «О рекламе»); подробности и ссылки — в разборе нативной рекламы с нейросетью.
- Доступы — минимальные. Публикатору не отдавай основной пароль хостинга: заведи отдельного пользователя с правом только на папку страниц, а ключи храни вне общего файла памяти, который читают все агенты.
Тот же приём — рой субагентов в плагине Cursor — Артур через три месяца показал на другой задаче: нарезка эфиров на шортсы плагином Hyperion. Там видно, как такой конвейер развивается: больше проверок и обкатка в полуавтомате, прежде чем отпускать его на автопилот.
С чего начать сегодня
- Выбери одну страницу-образецТема, по которой у тебя есть свой опыт или данные. Разложи, какие шаги ты делаешь руками: ключи, источники, текст, блоки, вёрстка, проверка.
- Заведи роли и общий файлПо субагенту на шаг в .cursor/agents/ (или .claude/agents/), одна задача у каждого. Все пишут в один handoff.md и читают из него.
- Пропиши директору порядок и «без вопросов»Параллельно — только независимые шаги. Субагент сам проверяет свой итог; два отказа подряд — остановка и сводка.
- Поставь в конце двух проверяющихБраузер со скриншотами и SEO/GEO-аудит по открытому чек-листу: быстрый ответ, видимая структура, никакого скрытого текста.
- Публикуй самКонвейер кладёт страницу в черновики. Ты читаешь, добавляешь своё, помечаешь рекламу и только потом публикуешь.
- Замерь до и послеДо запуска запиши исходные цифры (трафик страницы, позиции, долю в «Видимости сайта в Алисе AI»), дату публикации — и сравни через несколько недель. Учти, что инструмент Яндекса обновляется раз в неделю и видит не все запросы.
Вопросы и ответы
Q1Что такое GEO-оптимизация сайта?Кратко: Подготовка страниц к тому, чтобы на них опирались ответы нейросетей в поиске: быстрый ответ, честная структура, источники.
GEO (generative engine optimization) — оптимизация под генеративные ответы: быстрые ответы Алисы AI в Яндексе, AI Overviews в Google, чаты с поиском. Главный приём из доклада — прямой ответ на запрос в первом блоке. По официальным справкам Google и Яндекса, отдельных требований нет: нейросети опираются на страницы, которые и так хорошо ранжируются и полезны людям, поэтому GEO — это продолжение нормального SEO, а не замена.
Q2Нужен ли сайту файл llms.txt?Кратко: Не обязателен: это предложение сообщества, Google прямо пишет, что такие файлы для его ИИ-ответов не нужны.
llms.txt — Markdown-файл в корне сайта с описанием и ссылками на главные страницы, чтобы ИИ-агентам было проще ориентироваться. Его предложил Джереми Говард в 2024 году, и это до сих пор предложение, а не стандарт. Сделать его недолго, но доказанной пользы для позиций нет: Google пишет, что для AI Overviews не нужны ни новые машиночитаемые файлы, ни особая разметка.
Q3Не забанят ли сайт за статьи, написанные нейросетью?Кратко: Наказывают не за нейросеть, а за массовые страницы без пользы, клоакинг и скрытый текст.
Google относит к нарушениям массовую генерацию страниц ИИ «без ценности для пользователей», Яндекс — малополезный контент и SEO-тексты. Если конвейер готовит черновики, а человек добавляет свой опыт и проверяет факты, — это работа с помощником. Если сто страниц пересказывают чужие новости или прячут текст от людей — риск санкций реальный.
Q4Чем субагент отличается от скилла?Кратко: Скилл — инструкция для того же агента, субагент — отдельный исполнитель со своим контекстом, который возвращает только итог.
Этот вопрос задали в чате доклада. Скилл подгружается в контекст основного агента, когда нужен. Субагент в Cursor — отдельный файл с ролью и своим окном контекста: он не видит всей переписки, делает свою часть и возвращает результат директору. Поэтому длинную работу удобнее раскладывать на субагентов, а повторяемые приёмы внутри роли — оформлять скиллами.
Q5Можно ли собрать такой конвейер не в Cursor?Кратко: Да: субагенты и хуки есть в Claude Code, субагенты — в Codex; Cursor даже читает их папки агентов.
В зале спрашивали и об этом, ответа на эфире не прозвучало. Сам принцип — роли, общий файл, порядок, проверки — от редактора не зависит. По документации Cursor, он читает файлы субагентов и из .claude/agents/, и из .codex/agents/, так что роли можно держать в формате, понятном нескольким инструментам. Разница — в цене прогона: Артур выбирал Cursor из-за дешёвой модели внутри подписки.
Q6Сколько времени и денег уходит на одну страницу?Кратко: По словам спикера — около 20–40 минут и около миллиона токенов на дешёвой модели внутри подписки Cursor.
Это оценка Артура на апрель 2026 года. На эфире прогон дважды зависал, так что закладывай запас. Тарифы и модели Cursor с тех пор поменялись — считай по актуальному прайсу, а дорогие модели оставь для отдельных задач вроде кода или дизайна.
♥ Промптов в статье: 3 — забирай на полку у каждого или открой все промпты статьи в библиотеке →
// Полезно? Сохрани — так я вижу, что писать дальше. Или отправь коллеге
Сохранённое — на полке, ссылка в шапке сайта.
// Дальше в выпуске № 16 · 8 из 8
 Генеративный контент · Александр ЮшкевичБесплатная транскрибация видео в текст и субтитры на своём компьютере: метод localhost вместо подписокТранскрибация видео в текст бесплатно на своём компьютере: метод localhost Александра Юшкевича — Whisper, FFmpeg, yt-dlp, бесплатные уровни API и своя замена Submagic.Читать дальше →
← Личный ИИ-агент на Claude Code: говоришь с ним голосом в Telegram, а он учится на твоих правкахВесь выпуск № 16 →
// Прочитать с ИИ
Скопируй промпт и вставь в свой ассистент — ChatGPT, Claude, GigaChat, Алису, DeepSeek. Он откроет материал по ссылке, перескажет суть и адаптирует приёмы под твою задачу.
Что в промпте
Разбери материал журнала «Нейрохакер» «GEO-оптимизация сайта конвейером субагентов: одна новость — одна страница без ручных «продолжить?»»: https://neyrohacker.com/geo-optimizaciya-sayta-subagenty-cursor/

1. Перескажи главную мысль в трёх предложениях.
2. Выпиши приёмы, которые можно применить сразу, — по шагам.
3. Задай мне три вопроса о моей задаче и адаптируй метод под мои ответы.
// Обсудить
Есть вопрос к спикеру или по материалу? Задай его в открытом NeyroCommunity — там обсуждаем доклады саммита, отвечаем на вопросы к спикерам и разбираем материалы журнала.
9 000+ участников в чате сообщества
- вопросы спикерам саммита
- обсуждение докладов и материалов журнала
- общаться и помогать другим
бесплатно · откроется бот в Telegram, он пришлёт приглашение в чат
// Нейрохакер+
Готовые скиллы и нейрогайды под такие задачи
Промпты и скиллы, которые запускаются сразу, и нейрогайды по докладам саммита
Оформить подписку1 990 ₽, далее 990 ₽/месБиблиотека скиллов и нейрогайдов регулярно пополняется.
Подписка с автопродлением. Отменить — в один клик в личном кабинете, без объяснений.
Подписка уже есть? Войти в кабинет →